Jianmu 产品与架构概览
本文面向产品经理、业务负责人、合作方,以及希望快速理解 Jianmu 的非核心开发人员。它不打算解释每个模块怎么实现,而是回答几个更直接的问题:Jianmu 是什么、为什么这样设计、它适合解决什么问题、和主流 Agent 框架有什么不同。
目录
- Jianmu 是什么
- 1.1 一句话定位
- 1.2 Jianmu 关注的不是“让 LLM 调工具”
- 1.3 三个核心设计目标:复杂编排、自治运行、长时运行
-
1.4 从核心目标到 Runtime 模块
- 2.1 从最简单的 Agent 开始
- 2.2 Agent 进入真实业务后会发生什么
- 2.3 Jianmu 解决的是 Agent Runtime 问题
-
2.4 什么时候应该用 Jianmu
- 3.1 产品架构总图
- 3.2 三个 Runtime 支柱:Structured / Reactive / Durable
- 3.3 运行内核:Runner / Node / State
- 3.4 生命周期与持久化:Suspend / Resume / Checkpoint / Effects / Termination
- 3.5 治理:Guard / Approval / Sandbox / Permission
- 3.6 观测与扩展:Event / Telemetry / Hook
- 3.7 能力层:Model / Tool / Skill / Memory / Context / MCP / RAG
-
3.8 多智能体:Swarm
- 4.1 行为树承载的 Agent 循环
- 4.2 Runner:Event-driven Tick
- 4.3 Node / Tree / Preset:Agent Loop 与 Tree Skill 的共同基石
-
4.4 State / Port Binding:节点之间如何共享数据
- 5.1 等待不是异常:Suspend / Resume
- 5.2 什么时候应该停止:Termination 也是 Runtime 语义
- 5.3 恢复不只是恢复状态:Effects、Commit Boundary 与 Reconciliation
-
5.4 一个完整任务示例
- 6.1 人如何进入 Agent 的执行闭环
- 6.2 Guard / Approval / Sandbox
-
6.3 Hook、Guard、Approval 的边界
- 7.1 为什么长期运行的 Agent 不能是黑盒
- 7.2 Event Bus:Runtime 里发生了什么
- 7.3 Telemetry:从事件到完整运行轨迹
- 7.4 Hook:在不修改主循环的情况下进入执行过程
- 7.5 从观察到干预:Hook 能改变什么
-
7.6 为什么这一层决定了 Jianmu 能不能真正产品化
- 8.1 Model:Provider、Retry / Fallback 与 Streaming
- 8.2 Tool / MCP:连接外部世界
- 8.3 Skill:把经验沉淀成能力
- 8.4 Tree Skill:企业确定性的主要沉淀方式
-
8.5 Context / Memory / RAG:模型看到什么、系统记住什么、外部取回什么
- 9.1 多 Agent 不等于“多个模型互相聊天”
- 9.2 Subagent、Agent Team 和 Swarm:同一个 Runtime 的不同自由度
- 9.3 Agent 是有生命周期的执行体
- 9.4 每个 Agent 都有自己的身份、状态、任务与 Mailbox
- 9.5 通信本身就是 Runtime 的一部分
- 9.6 消息就是事件:Agent 如何互相唤醒
- 9.7 Direct / Group / Topic:Swarm 中的通信网络
- 9.8 去中心化协作:没有必须掌控全局的总指挥
- 9.9 Liquid Topology:组织结构随着任务动态变化
- 9.10 Agent 创建 Agent:协作网络可以自己生长
- 9.11 长时 Swarm:生命周期、Mailbox、Snapshot 与恢复
- 9.12 Swarm 如何处理重复执行、并发与幂等
-
9.13 Jianmu 的“去中心化”到底指什么
-
- 10.1 从一次成功执行到可复用能力
- 10.2 Capability Loop:执行 → 验证 → 沉淀 → Skill → 复用
- 10.3 从运行证据到候选能力
- 10.4 验证、晋升与回滚
- 10.5 从能力积累到持续改进 / RSI
-
- 11.1 不同框架在解决同一个问题
- 11.2 LangGraph:State Graph 与 Durable Execution
- 11.3 AgentScope:Agent-centric Application Framework
- 11.4 AutoGen:Event-driven Multi-Agent Runtime
- 11.5 Jianmu:Behavior Tree as Agent Runtime
- 11.6 为什么 Jianmu 选择行为树
-
- 12.1 TUI Chat
- 12.2 Tree Studio
- 12.3 Swarm Studio
- 12.4 Seedbot / 业务 Agent
- 12.5 同一个 Runtime,不同产品形态
-
Jianmu 与 Agent Engineering 的演进
- 13.1 Harness Engineering:可靠执行环境
- 13.2 Loop Engineering:自治执行闭环
- 13.3 Structured Orchestration:复杂控制结构
- 13.4 Jianmu 为什么会自然汇聚到这些问题
-
- 14.1 Agent 是有生命周期的执行体
- 14.2 模型负责判断,Runtime 负责让事情继续发生
- 14.3 稳定的部分结构化,不确定的部分交给模型
- 14.4 等待、失败、人介入和恢复都应该是正常运行状态
- 14.5 Tree Skill 让能力积累,Swarm 让多个执行体持续协作
- 14.6 Jianmu 的边界:它是 Runtime,不是所有问题的答案
1. Jianmu 是什么
本章用途:先把 Jianmu 说清楚。
1.1 一句话定位
Jianmu 是一个以行为树承载 Agent Loop 的 Runtime,主要面向复杂编排、自治运行和长时任务。
它解决的是 Agent 在真实业务里会遇到的问题:一次行动循环怎么持续推进,任务做到一半要等人怎么办,程序重启后怎么继续,一个 Agent 不够时怎么协作,以及一套已经跑通的做法怎么沉淀成可复用、可治理的 Tree Skill。
Jianmu 的定位不放在 agentic workflow 那一层。它的底层仍然是现代 Agent:模型可以观察环境、判断下一步、调用工具、读取反馈并继续行动。Jianmu 做的是把这个 ReAct 内核循环放进行为树里,由事件驱动 Runner 持续 tick;再通过 Tree Skill 和治理层,把稳定下来的行为变成可复用、可审计、可干预、可恢复的企业级能力。
可以把大模型和 Jianmu 的关系简单理解成:
大模型负责判断下一步做什么,Jianmu 用事件驱动的行为树 tick 让这个判断持续、可控地变成行动。
1.2 Jianmu 关注的不是“让 LLM 调工具”
最简单的 Agent 并不难做。给模型一些工具,让它根据用户问题选择工具、读取结果、继续推理,就已经可以完成不少任务。真正麻烦的是任务变长、流程变复杂以后,Agent 该怎么运行。
比如一个订单处理 Agent,可能先要查订单和库存,再判断风险;遇到异常要换一条处理路径;涉及退款时要等人工审批;审批可能十分钟后才回来;中间某个外部接口还可能失败,需要重试或者降级。如果任务进一步拆给多个 Agent,它们还要互相发消息、等待结果,并知道各自做到哪里。
Jianmu 把处理现实中复杂执行所需要的能力建模成了完整且自洽的 Runtime。模型、Tool、Skill 都可以接进来,但任务状态、行为树 tick、等待与恢复、多 Agent 协作、安全控制等问题,不需要每个业务重新用 Prompt 和胶水代码拼一遍。
1.3 三个核心设计目标:复杂编排、自治运行、长时运行
Jianmu 的设计重点可以归纳成三个方向。
复杂编排
模型越来越强后,很多日常任务并不需要提前写成一张完整 Workflow。一个 ReAct Agent 自己看信息、调工具、读结果、继续判断,已经可以完成不少工作。
但真实业务里的 Agent 运行久了以后,问题会变多。它会遇到重试、降级、等待、审批、回调、子任务和多 Agent 协作。靠模型每一轮临场规划,前期很快;到了复杂场景,执行逻辑就容易散在 Prompt、工具代码和业务判断里。
Jianmu 使用行为树作为 Agent Runtime 的 Loop 内核。行为树最早用于游戏 AI 和机器人领域,是一种将决策逻辑与执行逻辑统一表示的树形模型。与传统流程图不同,行为树中的节点不仅表示一个步骤,还可以表示条件选择、顺序执行、并行执行、循环、重试等控制行为。
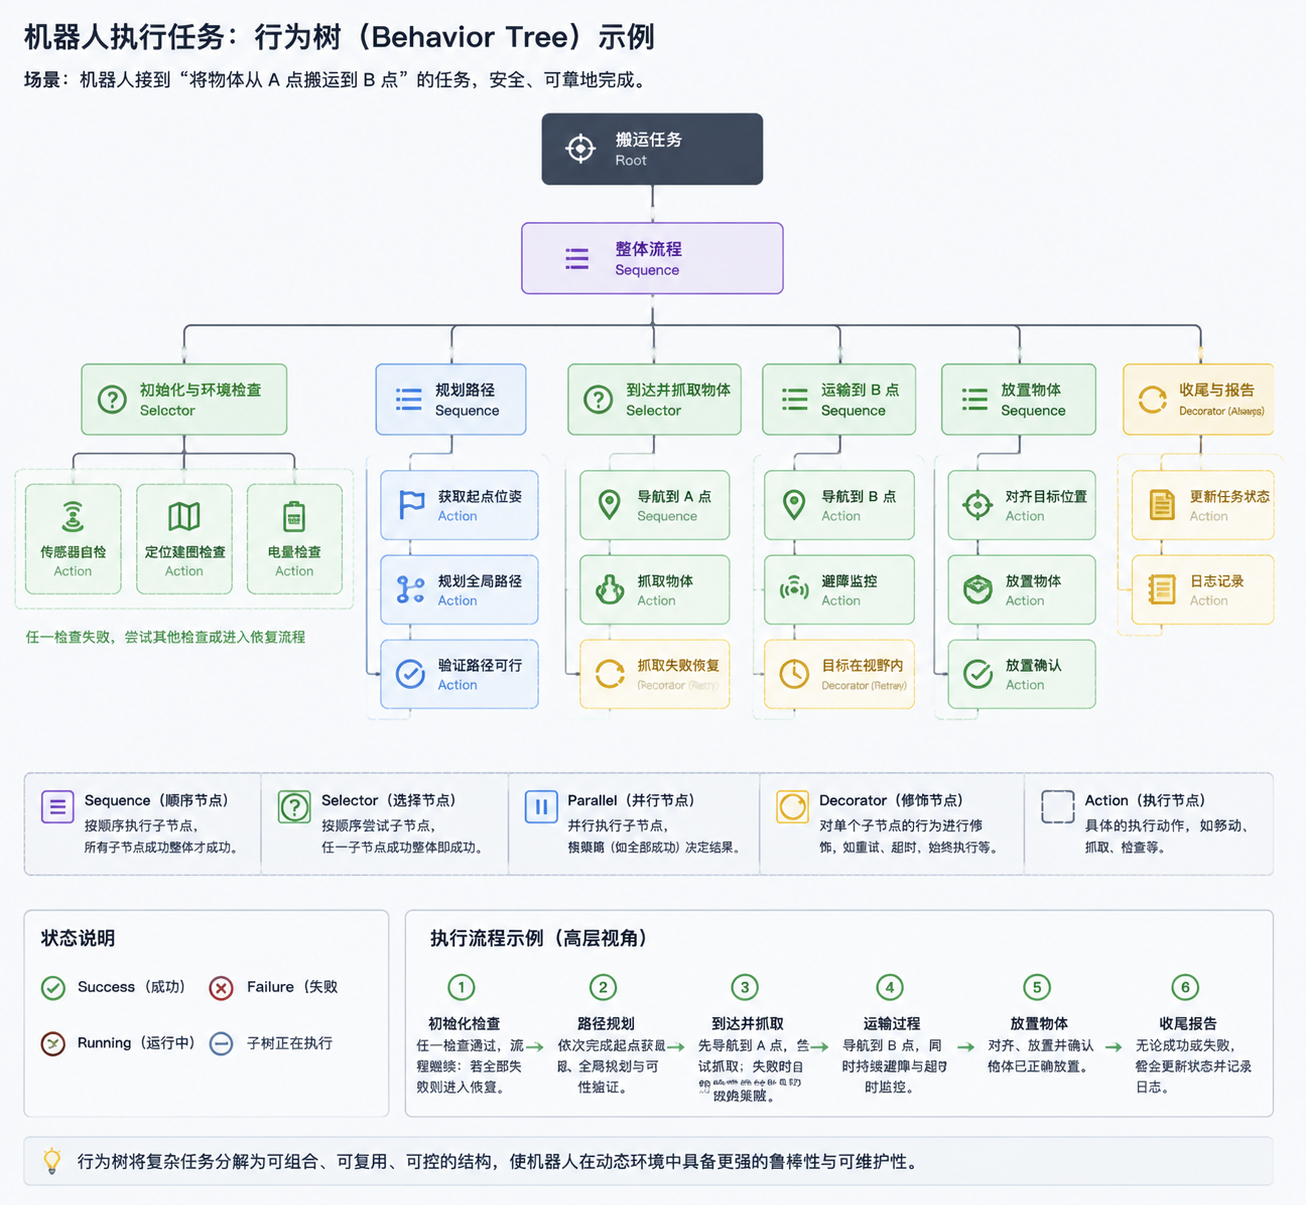
图:用行为树拆解“将物体从 A 点搬运到 B 点”任务。
相比通用的图结构,复杂流程在节点和跳转增多后容易形成难以阅读的“面条图”;而树结构天然具有层级结构,可以逐层拆解复杂度,使整体结构更容易理解和维护。
关键在于,Jianmu 的底层循环仍然是 Agentic 的。模型可以持续判断、选择工具、读取结果并继续行动;行为树负责构建这个 ReAct 循环,让它可以被 Runner 推进、暂停、恢复和观察。复杂业务编排主要放在 Tree Skill 这一层,同样使用 Node / Tree 表达结构,但面向的是稳定业务能力,而不是把内层 Agent Loop 写得很复杂。
自治运行
自治系统指的是不依赖外部人工输入、能自觉感知外部环境变化而作出行动的系统。
Jianmu 把行为树的 tick 执行和事件机制结合起来。Agent 不需要靠外部输入一遍遍手动触发:状态发生变化、收到新消息、异步任务完成,或者之前等待的外部结果回来后,Runtime 可以继续推进执行。
长时运行
Jianmu 围绕 Agent 构建了完整的生命周期。任务可能很快完成,也可能中间等待外部系统、人工审批或其他 Agent。Jianmu 会管理任务状态和执行进度,并通过 checkpoint、挂起与恢复等机制,让任务在中断之后能够继续推进,而不是只能从头再来。
行为树在这里提供稳定的执行结构,Runtime 则负责状态、事件和恢复。两者共同构成了 Jianmu 的长时运行能力。
1.4 从核心目标到 Runtime 模块
前面三个目标会自然落到几组 Runtime 模块上。
如果把 Jianmu 展开成一棵 Runtime 设计树,大致可以这样看。
flowchart LR
    ROOT["Jianmu Agent Runtime"]

    EX["运行内核<br/>Runner · Node/Tree · State"]
    DU["生命周期与持久化<br/>Suspend / Resume · Checkpoint<br/>Effects · Termination"]
    GO["治理<br/>Guard · Approval · Sandbox · Permission"]
    OB["观测与扩展<br/>Event · Telemetry · Hook"]
    CA["能力层<br/>Model · Tool · Skill · Memory<br/>Context · MCP · RAG"]
    SW["多智能体<br/>Swarm"]

    ROOT --> EX
    ROOT --> DU
    ROOT --> GO
    ROOT --> OB
    ROOT --> CA
ROOT --> SW| 核心目标 | 主要依赖模块 |
|---|---|
| 复杂编排 | Tree Skill(基于 Node / Tree) |
| 自治运行 | 行为树承载的 ReAct Loop、Runner、Event、State、Model、Tool |
| 长时运行 | Suspend / Resume、Checkpoint、Effects、Termination |
企业化需要的确定性主要由 Tree Skill 承担。Tree Skill 使用同一套 Node / Tree 表达能力,把稳定业务做法组织成可复用、可审计、可测试、可版本管理和可回滚的能力。
除了这三条主线,Jianmu 还需要治理、观测、能力接入、经验复用和多智能体协作等支撑模块。它们不是新的核心目标,而是让这三个目标能够在真实系统里成立。
2. 为什么需要 Jianmu
本章用途:从普通 Agent 的能力边界出发,说明为什么当任务变复杂以后,光有模型、Prompt 和 Tool 还不够。
2.1 从最简单的 Agent 开始
一个最简单的 Agent,通常可以理解成三样东西:模型、Prompt 和 Tool。
用户提出任务后,模型判断要不要调用工具;拿到工具结果后,再决定下一步,直到给出答案。对于一次性、短流程的任务,这种方式已经很好用。
比如:
- 查一个订单状态;
- 根据几份资料生成总结;
- 调一个接口查询库存;
- 根据用户要求生成一份报表。
这类任务有一个共同点:生命周期很短,执行过程也比较简单。
很多时候,一个 ReAct 循环,甚至一段普通业务代码,就够了。Jianmu 并不是为了替代这些简单方案。
问题出现在任务开始变长以后。
原本的一次模型调用,可能变成十几步执行;原本只有一个工具,后来需要调用多个业务系统;原本一次请求内就能完成,后来开始出现等待、审批、回调、失败重试和多 Agent 协作。
这时候,Agent 的难点会慢慢从“模型下一步想什么”,转移到“这件事到底怎么持续跑下去”。
2.2 Agent 进入真实业务后会发生什么
真实业务很少是一条从头走到尾的直线。
还是以一个订单异常处理 Agent 为例。
它可能先查询订单信息,然后检查库存和支付状态。如果只是普通异常,可以自动处理;如果金额较大,需要人工审批;如果库存系统暂时不可用,要过一会儿再试;如果问题涉及物流,还需要把一部分任务交给另一个 Agent;等对方返回结果以后,再决定最终怎么处理。
于是几个很现实的问题会同时出现。
流程会越来越复杂。
分支、重试、降级、并行任务、等待条件不断增加。如果这些逻辑全部堆在一段 Prompt、一个 while 循环或者一张不断扩大的流程图里,早期可能还能维护,后面会越来越难看清楚“现在为什么走到这里”。
任务会停下来。
Agent 不可能一直占着线程等待。它可能要等人工审批、用户补充信息、外部系统回调,甚至等另一个 Agent 几分钟以后才返回结果。
这时候系统需要知道:为什么停、停在哪里、等什么,以及条件满足以后从哪里继续。
执行会失败。
真实的工具调用会超时,接口会报错,进程会重启,模型也可能给出不符合预期的结果。
如果任务已经执行了很多步骤,中途出错后全部从头开始,不但浪费成本,还可能把已经执行过的真实操作再执行一次。
有些动作不能让 Agent 自己决定。
查数据和发起退款不是一回事。读一个文档和删除一批数据也不是一回事。
当 Agent 开始操作真实业务系统,就需要权限、审批、预算、频率限制、执行隔离,以及一套能看清楚“它刚才到底做了什么”的记录。
一个 Agent 也可能不够。
复杂任务经常天然包含不同角色:有人负责分析,有人负责查资料,有人负责执行,有人负责检查结果。
这时问题又会变成:这些 Agent 怎么创建、怎么发消息、怎么等待彼此、一个 Agent 挂掉以后怎么办,以及整个团队的状态怎么保存。
最后还有一个更长期的问题:
同样的事情,为什么每次都要重新想一遍?
如果某套处理流程已经被反复验证过,系统应该能把它留下来,下一次直接复用,而不是每次重新让模型规划一遍。
这些问题放在一起看,就会发现它们并不属于某一个 Prompt,也不属于某一个模型。
它们属于 Agent 的运行过程本身。
2.3 Jianmu 解决的是 Agent Runtime 问题
Jianmu 就是在这个位置上出现的。
它不替模型负责“变聪明”,也不要求所有业务都改成一种固定写法。它主要负责模型做出决定以后,整个 Agent 任务怎么被组织、推进、暂停、恢复和约束。
可以把一套完整的 Agent 系统粗略拆成两部分:
模型 / Prompt / RAG
        ↓
   决定下一步做什么
        ↓
----------------------
        ↓
      Jianmu
        ↓
怎么执行、怎么等待、怎么恢复、怎么协作、怎么受控
        ↓
Tool / Skill / 外部系统 / 其他 Agent
上半部分更偏“智能”,下半部分更偏“运行”。
Jianmu 主要做的是后者。
这也是为什么 Jianmu 更适合被理解成 Agent Runtime,而不只是一个行为树库或者一套 Agent SDK。
行为树是它组织复杂控制逻辑的核心结构,但 Jianmu 真正提供的是围绕这个结构的一整套运行能力:状态管理、事件驱动、挂起与恢复、checkpoint、Tool 和 Skill、多 Agent、Guard、Sandbox、Telemetry 等。
这些能力单独看都不神秘。真正重要的是,它们被放在同一个运行模型里以后,很多原本需要业务层自己处理的问题就有了统一的语义。
比如:
- 等人工审批和等外部回调,本质上都可以看作“任务暂时挂起”;
- 工具执行失败和子任务失败,都可以进入统一的重试或降级路径;
- 单 Agent 和多 Agent 都有明确的生命周期;
- 任务状态和执行进度可以一起保存,而不是只保存一段聊天记录。
所以,Jianmu 想解决的并不是“怎么更快做出一个 Demo Agent”,而是另一个阶段的问题:
当 Agent 已经能做事以后,怎么让它在复杂、真实、会中断的环境里继续把事情做完。
2.4 什么时候应该用 Jianmu
不是所有 Agent 都需要 Jianmu。
如果需求只是一次模型调用、几个简单 Tool,或者一条很短的固定流程,直接使用模型 SDK、普通代码、成熟的 ReAct Agent 或任务队列,往往更简单。
Jianmu 真正开始体现价值,通常是在 Agent Loop 本身变复杂以后。比如任务逐渐出现:
- 多层分支、Retry、Fallback 和并行控制;
- 异步任务、外部回调、等待用户或审批;
- 一个任务跨越多次请求、进程重启甚至更长时间;
- 高风险动作需要 Guard、Approval、Sandbox 和审计;
- 外部副作用不能因为恢复而被重复执行;
- 多个 Agent 需要有独立生命周期并持续协作;
- 已经跑通的做法希望沉淀为 Tree Skill,而不是每次重新规划。
可以粗略理解成:
单轮问答 / 简单 Tool Calling
→ 普通 SDK 往往足够

简单、固定的线性流程
→ 代码 / DAG 往往更直接

行为树 Agent Loop + 等待 + HITL + 恢复
→ 开始进入 Jianmu 擅长的范围

长时自治 + 真实副作用 + 多 Agent + Tree Skill 沉淀
→ Runtime 的价值会越来越明显
但这里有一个很重要的现实:真实生产环境往往比 Demo 复杂得快得多。
一个原本看起来只是“LLM 调三个 Tool”的功能,上线以后很容易继续出现:权限怎么控制、接口超时怎么办、用户中途取消怎么办、金额太大谁审批、服务重启以后怎么恢复、动作到底有没有执行成功、多个任务并发会不会重复、出了问题怎么追踪。
这些需求通常不是一次性全部出现,而是随着产品真正接触用户和业务,一层一层长出来。
所以“什么时候需要 Jianmu”的门槛,并不一定是系统已经复杂到肉眼可见的程度。很多真实业务一旦要求可靠、持续、可控地执行,其实很快就会跨过这个门槛。
Jianmu 不是为了把简单 Agent 改造成 Workflow,而是为了在 Agent Loop 变长以后,让运行、等待、恢复和能力沉淀都有明确位置。
3. Jianmu 的整体产品架构
本章用途:先看全貌。这里讲每一层为什么存在,不深入模块实现。
3.1 产品架构总图
如果只从产品角度看,Jianmu 可以分成几层:最上面是具体产品和业务应用,中间是 Agent 本身,下面是负责持续运行的 Runtime。Runtime 内部再拆成几组相对稳定的模块,负责执行推进、生命周期、治理、观测扩展、能力接入和多智能体协作。
flowchart TB
    APP["产品 / 业务应用<br/>TUI Chat · Tree Studio · Swarm Studio · Seedbot · 业务系统"]

    AGENT["Agent / Agent Swarm<br/>理解任务 · 做出判断 · 协作分工"]

    subgraph RUNTIME["Jianmu Agent Runtime"]
        EX["运行内核<br/>Runner · Node/Tree · State"]
        DU["生命周期与持久化<br/>Suspend / Resume · Checkpoint<br/>Effects · Termination"]
        GO["治理<br/>Guard · Approval · Sandbox · Permission"]
        OB["观测与扩展<br/>Event · Telemetry · Hook"]
        CA["能力层<br/>Model · Tool · Skill · Memory<br/>Context · MCP · RAG"]
        SW["多智能体<br/>Swarm"]
    end

    WORLD["外部能力与业务世界<br/>模型服务 · 工具服务 · 知识库 · 人工审批 · 业务系统"]

    APP --> AGENT
    AGENT --> RUNTIME
    CA --> WORLD

    EX --> DU
    EX --> GO
    EX --> OB
    EX --> CA
    EX --> SW
    GO -.约束动作.-> CA
    OB -.运行记录.-> APP
    DU -.保存进度.-> EX
这张图里,最值得注意的是 Agent 和 Runtime 被分开了。
Agent 更像“做决定的人”,负责理解任务、判断下一步、选择工具或 Skill,必要时把任务交给其他 Agent。
Runtime 负责让事情持续跑下去。它要知道现在执行到哪里,什么时候该继续 tick,为什么暂停,出错以后怎么办,程序重启以后怎么恢复,以及多个执行体之间怎么协调。
Jianmu 的 Runtime 把 Agent 的 ReAct 式行动循环放进行为树里运行。模型仍然负责判断和选择,行为树负责控制执行路径,状态和事件负责让这个循环可以暂停、恢复和继续。
所以 Jianmu 更接近现代 Agent Runtime,而不是一套 agentic workflow builder。workflow 更像提前定义好路径,再让模型填充局部判断;Jianmu 的内核循环仍然是 Agent 在观察、判断、行动和读取反馈,只是这个循环被行为树组织起来,并由事件驱动机制推进。
Tree Skill 位于更上层。它处理的是另一件事:当某段 Agent 行为已经稳定下来以后,把它整理成一棵可复用的树。企业场景要的确定性,主要就落在这里。模型仍然可以处理不确定判断,但已经验证过的步骤、边界、审批和失败处理,可以通过 Tree Skill 固定下来。
所以 3.1 先按产品模块看全貌。下一节再把这些模块背后的运行语义抽象成 Structured、Reactive 和 Durable 三个支柱。
3.2 三个 Runtime 支柱:Structured / Reactive / Durable
Jianmu Runtime 里最核心的东西,可以先不按代码模块看,而是看成三个支柱。
| 支柱 | 解决的问题 | Jianmu 里的主要做法 |
|---|---|---|
| Structured Control | 稳定业务能力越来越复杂以后,执行逻辑怎么保持清楚 | Tree Skill、层级子树、Retry、Fallback、Wait 等控制结构 |
| Reactive Execution | Agent 怎么在有变化时继续跑,而不是靠人工反复触发 | Event-driven Runner、Behavior Tree Tick、消息与状态变化唤醒、Suspend / Resume |
| Durable State | 任务跨等待、跨中断以后,怎么知道之前做到哪里 | State、Context、Checkpoint、Memory、执行状态恢复 |
这三个东西不是互相独立的功能。
比如一个退款任务正在等审批:行为树知道当前流程走到“审批”这一步;Runtime 把任务挂起,不再无意义地循环;Checkpoint 保存当前状态;等审批结果回来以后,一个事件重新唤醒任务,然后从原来的位置继续。
如果只有 Behavior Tree,没有事件和状态恢复,它更像一个结构清楚的流程执行器。
如果只有事件循环,没有结构化控制,Agent 可以一直运行,但复杂流程还是容易慢慢堆成大量判断和胶水代码。
如果只有状态持久化,也只能回答“之前保存了什么”,不能自然回答“接下来该从哪一步继续”。
Jianmu 想做的是把这三件事放进同一个执行模型里。底层循环仍然是 Agent 在感知、判断、行动、观察结果;只是这个循环不直接写成一段不可控的 while loop,而是通过事件驱动的 Runner 和行为树 tick 承载起来。
这也对应了前面提到的三个设计重点:
- 复杂编排主要落在 Tree Skill;
- 自治运行主要来自 event-driven Runner 和 Behavior Tree tick;
- 长时运行依赖 Reactive Execution 和 Durable State 一起工作。
3.3 运行内核:Runner / Node / State
运行内核是 Jianmu 最内层的一组模块。Runner 负责在事件到来时推进 Runtime,Node 承载行为树中的具体行为并构成 Tree,State 保存任务当前状态。
flowchart LR
    R["Runner<br/>推进 tick / 处理唤醒"] --> N["Node/Tree<br/>承载行为与控制结构"]
    N --> S["State<br/>保存任务状态与节点数据"]
    S --> R
Runner、Node 和 State 不是三块彼此独立的功能。Runner 每次被事件唤醒时会 tick 行为树,Node 根据当前输入和状态执行,执行结果再写回 State。State 的变化又可能触发下一次唤醒。自治运行的基本循环就在这里形成。
Node / Tree 这一层也为 Tree Skill 提供表达基础。内核循环用它构建 ReAct 或 Plan-Execute;到了能力层,Tree Skill 再用同一套结构承载更复杂的分支、重试、降级、子流程和能力复用。
3.4 生命周期与持久化:Suspend / Resume / Checkpoint / Effects / Termination
生命周期与持久化处理任务如何跨时间存在。真实任务不会总是一口气跑完,它可能要等外部系统、等人工审批、等异步结果,也可能在中途遇到进程重启和网络故障。
flowchart TB
    D["Durable Execution"]

    D --> CKPT["Checkpoint<br/>保存现场"]
    D --> SUSP["Suspend<br/>暂停执行"]
    D --> TERM["Termination<br/>明确结束原因"]
    D --> EFF["Effects<br/>记录外部副作用"]

    CKPT --> RES["Resume"]
    SUSP --> RES
    RES --> CONT["Continue Execution<br/>继续执行"]
Checkpoint 负责保存现场,Suspend 负责把任务暂停在一个明确的等待点。等待条件回来以后,Resume 接住之前保存的状态,让任务继续执行。
Termination 给结束一个明确原因。一个长时任务不能只有“还在跑”和“成功了”两种状态,也需要知道它是被用户取消、被策略终止、超时结束,还是因为错误无法继续。
Effects 处理已经影响外部世界的动作。比如发起退款、发送消息、写入业务系统,这类动作一旦跨过边界,就不能只靠“节点有没有执行过”来判断。Runtime 需要记录这些副作用,避免恢复和重试时把同一件事做两遍。
3.5 治理:Guard / Approval / Sandbox / Permission
治理让自治运行有边界。Agent 可以自己推进任务,但进入真实业务以后,不能默认所有动作都可以直接执行。
flowchart LR
    ACT["准备执行动作"] --> PERM["Permission<br/>是否具备权限"]
    PERM --> GUARD["Guard<br/>根据上下文判断风险"]
    GUARD -->|可直接执行| EXEC["执行"]
    GUARD -->|需要确认| APP["Approval<br/>人工审批"]
    GUARD -->|需要隔离| BOX["Sandbox<br/>隔离执行"]
Permission 描述 Agent 拥有什么权限,更像一组边界事实。Guard 是运行时的判断点,它会结合权限、上下文、动作类型和业务策略,判断这次动作能不能做。
Approval 和 Sandbox 是常见处理结果。需要人确认的动作会进入 Approval,任务可以挂起,等审批结果回来以后再恢复。高风险代码或外部执行可以放进 Sandbox,减少对宿主环境的影响。
这样设计的目的很直接。安全控制不应该散落在每个 Tool 和每段业务代码里,Runtime 需要在执行链路上给出统一边界。
3.6 观测与扩展:Event / Telemetry / Hook
观测与扩展层记录 Runtime 中发生了什么,并给外部系统留下观察和介入的入口。
flowchart LR
    R["Runtime 执行过程"] --> P["关键执行点<br/>Runner / Node / Model / Tool"]

    P --> H["Hook<br/>外部逻辑接入"]
    H --> P

    P --> E["Event<br/>发出运行时信号"]
    E --> T["Telemetry<br/>组织成运行轨迹"]

    T --> O["Trace / Metrics / Logs<br/>调试、审计、监控"]
Event 偏向运行时语义,是 Runtime 发出的离散信号。比如节点开始、工具调用完成、任务挂起、审批创建、任务恢复等。它回答的是 Runtime 里发生了什么。
Telemetry 偏向观测系统。它会把一次运行中的事件、耗时、错误、工具调用、模型调用和上下文信息组织成可查看、可分析、可审计的轨迹。它回答的是这次运行完整经历了什么。
Hook 解决外部系统如何在关键点接进来。产品可以在模型调用前补充上下文,在工具执行前做额外检查,在任务挂起时更新 UI,或者把某些事件同步到业务系统。Hook 可以进入执行链路,但它不应该变成任意改写 Runtime 语义的万能入口。
3.7 能力层:Model / Tool / Skill / Memory / Context / MCP / RAG
Runtime 自己不会凭空完成业务,它需要连接真正的能力。能力层负责把模型、工具、知识、上下文和可复用做法接进 Jianmu。
Model 负责理解、生成和判断。Tool 负责真正接触外部世界,比如查数据库、调用接口、运行代码、访问业务系统。MCP 让外部工具和资源可以用统一方式接入。
Context 把当前任务需要的信息组织给模型。Memory 和 RAG 提供不同来源的历史经验和外部知识。Skill 则把已经验证过的做法沉淀下来,让后续 Agent 可以直接调用。
可以简单理解成:
这几个部分刻意没有绑死在一起。同一棵执行树可以换模型,同一个 Skill 可以被不同 Agent 调用,Tool 可以来自本地代码、MCP 或业务系统。这样业务能力不会全部粘在某一个 Agent Prompt 里。
3.8 多智能体:Swarm
多智能体层的 Swarm 把同一套 Runtime 思路扩展到多个 Agent 的协作场景。
在 Jianmu 里,Agent 不只是一次模型调用。它有自己的任务、状态、能力和生命周期。对于简单任务,可以只有一个 Agent;任务复杂以后,也可以组织成 Agent Team,或者进一步进入 Swarm。
单 Agent 和多 Agent 共用同一套 Runtime 思路。一个 Agent 在等用户输入,和另一个 Agent 在等同伴返回消息,本质上都可能处于“现在没有条件继续,需要等待事件”的状态。一个 Agent 需要保存执行进度,一个团队同样需要保存成员、消息和协作进度。
所以 Jianmu 的多 Agent 不是单独外挂的一套聊天机制,而是把 Agent 当作可以被 Runtime 管理的执行体。Swarm 负责让多个这样的执行体能够创建、通信、等待彼此,并共同完成任务。
后面的第 9 章会展开 Swarm、消息和动态协作。这里先保留一个判断:
一个 Agent 不够时,Jianmu 可以增加新的执行体,而不是把所有复杂度继续塞进一个 Agent 里。
4. 运行内核:Runner、Tree、Node 与 State
本章用途:解释 Jianmu Agent 怎么跑起来。这里先看 Runtime 如何被事件唤醒、如何推进行为树、节点如何执行动作,以及 State 如何参与每一轮执行。
4.1 行为树承载的 Agent 循环
先不看代码,一个 Jianmu Agent 跑起来以后,仍然是一个典型的 Agent 循环。它感知外部变化,读取当前状态,让模型或规则判断下一步,执行工具或 Skill,再把结果写回状态。
Jianmu 的差别在于,这个循环由行为树构建和承载,不再是一段裸的 ReAct while loop。换句话说,Jianmu 的内核循环可以理解为行为树构建的 ReAct:Reason、Act、Observe 和继续执行这些环节,落在行为树的节点、组合节点和状态传播上。
flowchart LR
    E["事件 / 输入"] --> S["更新状态"]
    S --> T["行为树 tick"]
    T --> R["Reason<br/>模型 / 规则判断"]
    R --> A["Act<br/>Tool / Skill / Agent"]
    A --> O["Observe<br/>结果 / 外部反馈"]
    O --> U["更新 State / 节点状态"]
    U --> T
    U --> W["等待下一次事件"]
    W --> E
这里的“事件”不只是用户发来一句话。
它也可能是:
- 一个异步 Tool 执行完成;
- 外部接口返回结果;
- 用户补充了之前缺失的信息;
- 审批结果到达;
- 另一个 Agent 发来消息;
- 某个业务状态发生变化。
事件到达以后,Runtime 会重新推进执行。行为树根据当前状态决定这次 tick 应该走到哪里,节点再去调用模型、Tool、Skill 或其他 Agent。动作产生新的结果,这些结果又会改变 State 和节点状态,后续事件再推动下一轮执行。
所以 Jianmu 里的 Agent 更接近一个持续响应变化的执行体,而不是“收到请求以后从头执行一遍固定函数”。
4.2 Runner:Event-driven Tick
Runner 负责回答一个很具体的问题:什么时候推进这棵行为树。
传统行为树常见于游戏 AI 和机器人系统。那里的行为树通常被外部主循环按固定频率 tick,比如每一帧 tick 一次,或者按照一个固定周期轮询。世界在持续变化,主循环也持续推进树。
Jianmu 面对的不是这种运行环境。一个企业 Agent 大量时间都在等外部世界:等 Tool 完成、等用户补充信息、等审批结果、等回调、等另一个 Agent 发来消息。如果还按照固定频率轮询 tick,Runtime 就会在很多没有新信息的时刻反复推进同一棵树。
Jianmu 的 Runner 采用 event-driven tick。
没事件时,不推进;有事件时,再唤醒 Runner,继续 tick 行为树。
这些事件可以来自:
- 用户输入;
- Tool 执行完成;
- 外部系统回调;
- 审批结果返回;
- State 发生变化;
- 另一个 Agent 发来消息;
- 定时任务或调度器触发。
sequenceDiagram
    participant R as Jianmu Runtime
    participant T as Behavior Tree
    participant X as Async Tool / External System

    R->>T: tick
    T->>X: 发起异步任务
    T-->>R: 当前节点 RUNNING
    Note over R: 没有新事件,等待
    X-->>R: 任务完成,发出 wake-up
    R->>T: 再次 tick
    T->>T: 根据新结果继续执行
这就是 event-driven tick 的核心含义。
行为树本身仍然保留 RUNNING、SUCCESS、FAILURE 这些节点状态,但 Runner 不再像传统行为树那样靠固定频率轮询 RUNNING 节点。一个节点如果正在等待异步结果,可以保持 RUNNING;Runner 暂时停下来。等结果回来,一个事件重新唤醒 Runner,再从当前状态继续 tick。
这点看起来只是调度方式不同,但它对长时 Agent 很关键。
传统轮询 tick 更适合持续在线、世界每一刻都在变化的场景。Jianmu 的 event-driven tick 更适合企业任务:大部分时候没有必要算,真正应该继续的时候,往往是因为外部世界送来了新事实。
事件驱动还有一个好处:Agent 的时间不需要和某个 HTTP 请求绑在一起。
一次 Web 请求可以结束,但任务本身还活着。后面新的事件到达时,再把这个任务继续唤醒。
这也是“长时运行”和“一个接口请求跑很久”的区别。
4.3 Node / Tree / Preset:Agent Loop 与 Tree Skill 的共同基石
Runner 解决“什么时候 tick”,Node / Tree 解决“tick 的时候执行什么”。
Node 是具体执行单元,可以是一次模型判断、一次 Tool 调用、一次状态检查、一次等待,也可以是一个 Skill 或另一个 Agent。
Tree 把这些 Node 组织起来。
Node / Tree 在 Jianmu 里主要用在两处。
第一处是 Runner 里的 Agent Loop。Jianmu 默认的内核循环可以理解为行为树构建的 ReAct,也可以扩展成 Plan-Execute 等其他循环形式。
ReAct Loop
├── Reason
├── Act
├── Observe
└── Continue / Stop

Plan-Execute Preset
├── Plan
├── Execute
└── Review
第二处是 Tree Skill。Tree Skill 也用 Node / Tree 来表达一套能力,但它面向的是更稳定的业务做法。
所以 Node / Tree 不是“复杂 workflow”的同义词。它们一方面用于构建 Runner 中的 ReAct、Plan-Execute 等现代 Agent 循环,另一方面用于构建 Tree Skill。复杂编排主要体现在 Tree Skill 这一层。
4.4 State / Port Binding:节点之间如何共享数据
Behavior Tree 解决“谁执行、先后关系是什么”,但一棵树真正跑起来以后,还需要另一条线:节点之间的数据怎么流动。
如果所有节点都随意读写一个无结构字典,简单任务当然能跑,但复杂以后很容易出现字段类型不一致、历史数据被覆盖、临时状态残留到下一轮等问题。
所以 Jianmu 希望 Agent 的运行状态有明确结构和数据契约,而不是靠每个节点之间的口头约定。
这里的 Typed State,指的是 State 里的关键字段有明确类型、含义和更新规则。节点不能随便往共享字典里塞字段,而是要知道自己读什么、写什么、写进去以后怎么合并,以及这个字段能活多久。
简单说,Typed 解决的是这类问题:
其中有两个特别重要的语义。
Reducer 决定一个新值写进来以后,是覆盖旧值,还是按照约定方式合并。比如消息历史通常更像“追加一条”,而不是“把整个历史替换掉”。这样“数据怎么合并”本身就是 State 的规则,不必散落在每个业务节点里。
Ephemeral 则解决“这个状态能活多久”。有些数据应该贯穿整个任务,有些只属于当前 run、当前 step 或当前模型调用。生命周期结束以后自动清理,能避免临时数据污染后续执行。
这和第 5 章的生命周期思想是一致的:状态不仅有值,也有自己的生命周期。
Port Binding 进一步让 Node 不必绑死某个业务字段名。节点只声明自己需要什么输入、产生什么输出,再把这些逻辑端口映射到当前业务 State。
flowchart LR
    A["Node A<br/>逻辑输出"] --> S["Typed State"]
    S --> B["Node B<br/>逻辑输入"]
    PA["Port Binding"] -.-> S
于是同一个 Node 或子树可以在不同业务里复用,而不用因为 State 字段名字不同就重写内部逻辑。
所以这一层最重要的结论是:
Behavior Tree 负责控制流,Typed State / Port Binding 负责数据流。
两者结合以后,Jianmu 的树才不仅是一组有层级关系的节点,而是一套有明确数据契约、可以持续运行和恢复的执行结构。
节点可以共享状态,但共享不等于随便改。
5. 生命周期与持久化:Suspend、Resume、Checkpoint、Effects、Termination
本章用途:解释 Jianmu Agent 如何跨越等待、中断和外部副作用继续存在。长时运行不只是把状态存下来,还要知道什么时候暂停、怎样恢复、为什么结束,以及已经影响外部世界的动作如何处理。
5.1 等待不是异常:Suspend / Resume
Jianmu 里有两种很容易混淆的“等”。
第一种是 Runtime 内部自己能等的东西,比如一个异步节点还在执行。这个时候 Agent 仍然处在运行周期里,只是 Runner 暂时没有必要继续 tick。
第二种是需要把控制权交回给外部世界的等待,比如:
- 需要人工审批;
- 需要用户补充信息;
- 需要某个外部系统代为执行,然后之后再把结果送回来。
这种情况下,Jianmu 会把任务正式挂起,也就是 Suspend。
目前 Runtime 原生支持三类挂起:
| 挂起类型 | 典型场景 | 等什么回来 |
|---|---|---|
| 审批等待 | 退款、删除、发布、高风险操作 | 批准 / 拒绝结果 |
| 用户输入等待 | 信息不完整,需要用户补充 | 用户提供的数据 |
| 外部执行等待 | 把动作交给外部系统处理 | 外部执行结果 |
挂起时,Runtime 会记录这次为什么暂停、对应哪个请求、需要什么数据才能恢复。对于需要把任务交还给宿主应用的场景,Jianmu 会在挂起点保存 checkpoint,然后把一个 suspended 结果返回给上层。
上层产品就可以正常结束当前请求。
例如 Web 页面可以显示:
此时 Agent 并不是“报错退出”,任务也不是消失了。
它只是停在一个明确的状态上。
等审批结果回来以后,上层把结果交还给 Runtime,Jianmu 再执行 Resume,从之前保存的位置继续。
flowchart LR
    A["执行到审批节点"] --> B["创建 Suspension"]
    B --> C["保存当前状态和执行位置"]
    C --> D["返回宿主:suspended"]
    D --> E["等待人工 / 用户 / 外部系统"]
    E --> F["结果回来"]
    F --> G["Resume"]
G --> H["从原流程继续执行"]这里最重要的一点是:Jianmu 不把等待人、等待系统当成异常。
真实业务本来就会停下来。问题不在于“怎么避免暂停”,而在于暂停以后还能不能清楚地知道:
- 为什么停;
- 停在哪;
- 等谁;
- 等什么数据;
- 数据回来以后怎么继续。
Jianmu 把这些信息放进 Runtime 的挂起/恢复协议里,而不是让每个业务自己再写一套 pending_status、回调表和恢复逻辑。
Checkpoint 在这里也不只是“保存几个变量”。
Jianmu 保存的是两个维度:一边是业务和运行状态,一边是行为树当前的执行状态。恢复以后,不只是“记得之前订单号是多少”,还要知道当前 Sequence / Selector 执行到了哪个子节点,哪些步骤已经跑过,接下来应该从哪里继续。这个区别很重要,只保存聊天记录或者业务字段,并不等于恢复了一个正在执行的 Agent。
5.2 什么时候应该停止:Termination 也是 Runtime 语义
长时运行很容易让人产生一个误解:
Agent 越自治,就应该越能一直跑下去。
其实正好相反。
一个真正可靠的 Runtime,不只是要知道什么时候继续,还必须知道什么时候不应该继续。
比如下面这些情况,语义完全不同:
外部接口还没返回
→ 等待,之后继续

需要用户补充信息
→ Suspend,拿到输入以后 Resume

模型暂时遇到可重试的服务错误
→ 当前尝试可以结束,宿主以后可能重新启动

API Key 错误
→ 继续 Retry 没有意义,应该明确终止

Agent 已经超过最大循环次数
→ 应该停止,而不是无限思考

Token Budget 已经耗尽
→ 应该停止,而不是继续花钱

用户明确拒绝审批
→ 当前高风险执行路径应该结束
如果所有这些情况最后都只变成一个:
上层产品其实很难知道接下来该怎么办。
是立刻重试?
是提示用户改配置?
是等一会再启动?
还是这次任务已经明确结束?
所以 Jianmu 在 Runtime 里保留了 Termination Record 这类终止语义。
它不只是记录“失败了”,还会记录为什么结束,以及宿主后续应该如何理解这次结束。
目前 Runtime 已经会区分一些典型原因,例如:
provider_error
provider_retry_exhausted
model_call_failed
hook_error
max_iterations_exceeded
budget_exceeded
approval_rejected
tool_denied
...
产品层不需要记住这些内部字符串,真正需要理解的是:结束本身也有类型。
例如模型 Provider 的错误可以分成两类。
第一类是用户可以直接修复、继续重试也没有意义的错误:
这类错误应该明确告诉宿主:
不要继续傻跑,先让用户解决配置或账户问题。
第二类是本次模型调用层的重试已经耗尽,但底层问题仍可能只是暂时性的:
这时候当前 Run 可以结束,但一个更高层的 Host 或调度系统以后仍然可以选择重新启动。
所以 Jianmu 更希望把:
和:
分开理解。前者是 Behavior Tree 里的局部控制语义。后者是 Runtime 生命周期语义。
从产品角度看,这会让 Agent 的状态更容易解释:
Running      → 正在工作
Waiting      → 暂时没事做,等事件
Suspended    → 控制权交给外部,之后可以 Resume
Completed    → 正常完成
Terminated   → 这次执行明确结束,并且有原因
这里最重要的一点是:
长时运行不等于永不停止。好的 Runtime 不仅知道怎么继续,也知道什么时候应该有理由地结束。
这和 Suspend / Resume 正好构成一对。
Suspend 回答:
“我现在不能继续,但以后还要回来。”
Termination 回答:
“这一次运行不应该再继续了,原因需要被保留下来。”
5.3 恢复不只是恢复状态:Effects、Commit Boundary 与 Reconciliation
前面总图里已经提到 Effects。这里需要把它和另外两个词放在一起看。
Effects 指 Agent 对外部世界产生的副作用。比如退款、发消息、写数据库、创建工单、发布内容。它们和内部 State 不一样,一旦发生,就不一定能通过恢复 checkpoint 撤回来。
Commit Boundary 是副作用真正跨出 Runtime、进入外部系统的边界。越过这条边界之前,系统还可以做 Guard、Approval、参数校验和取消;越过以后,Runtime 就必须把“外部世界可能已经改变”当成事实来处理。
Reconciliation 是恢复时的对账动作。当 Runtime 不确定某个 Effect 到底有没有成功时,不能靠猜,也不能简单重试,而是要向外部系统确认真实状态,再决定复用结果、补回 Receipt,还是重新执行。
三者的关系可以简单理解成:
Checkpoint 回答的是:
Agent 内部做到哪里了?
但只要 Agent 开始真正改变外部世界,还必须回答另一个问题:
这个动作到底已经发生了吗?
假设 Agent 调用支付系统退款。最麻烦的情况不是接口明确失败,而是:支付系统其实已经退款成功,但返回结果之前网络中断,Runtime 随后重启。
如果恢复以后只看到“退款节点还没完成”,然后把这个节点重新执行一次,就可能造成重复退款。
所以对付款、退款、发消息、发布内容、修改数据库、创建资源这类副作用,恢复不能简单等价于:
Jianmu 用 Governed Effect / Commit Protocol 把真正改变外部世界的动作放到一个明确的提交边界上:
flowchart LR
    P["Proposal<br/>准备做什么"] --> V["Validation<br/>允许做吗"]
    V --> R["Prepared<br/>留下提交意图"]
    R --> E["External Execution<br/>改变外部世界"]
    E --> C["Receipt<br/>取得外部回执"]
    C --> D["Committed<br/>确认已提交"]
这里最重要的是 Commit Boundary。
在越过这条边界之前,系统还可以做 Guard、Approval、业务校验;越过以后,Runtime 就必须把“这个动作是否已经发生”当成一等问题,而不能只看行为树节点有没有返回 SUCCESS。
如果已经有可信 Receipt,恢复时应该复用已经发生的结果,而不是重新产生副作用。真正困难的是结果不确定的情况:Runtime 知道动作已经准备执行,甚至请求可能已经发出,但没有拿到足够可信的最终结果。这时候应该进入 Reconciliation:先向外部系统确认事实,再决定下一步。
跨网络和外部系统的一致执行不能只依赖“这个函数调用过一次”,而需要把稳定的动作身份、幂等能力、Commit Record、Receipt 和 Reconciliation 组合在一起,让 Runtime 在重试和恢复时仍然保持一致的副作用语义:
不要因为 Runtime 重试或重启,把同一个业务决定再次作用到外部世界。
因此 Jianmu 的长时恢复实际上有两个维度:
只有两边都能回答,恢复才不仅是“程序继续跑”,而是业务意义上的继续执行。
5.4 一个完整任务示例
把前面的机制放到一个完整例子里会更直观。
假设我们做一个“异常退款处理 Agent”。用户给它一个任务:
检查订单 A1024 为什么没有正常完成,如果符合退款条件就处理退款。
第一步:接到任务
宿主应用创建任务,Jianmu 初始化 Agent 的状态和行为树。
Agent 首先读取订单信息。模型或规则判断需要查询订单、支付和库存状态,于是调用对应 Tool。
第二步:外部工具异步执行
订单接口很快返回,但支付系统查询需要一点时间。
行为树里的异步节点发起请求后处于 RUNNING。这时候 Runtime 不需要疯狂轮询,而是等待异步任务完成后的 wake-up。
支付结果回来以后,节点发出信号,Runner 再推进一次行为树。
第三步:根据结果选择路径
现在状态里已经有订单、支付和库存信息。
Agent 判断:用户确实支付成功,但订单因为库存异常没有履约,满足退款条件。
行为树进入退款分支。
这里的好处是,退款相关逻辑可以封装在一个独立子树里,而不是继续堆在最外层流程上。
第四步:执行前经过 Guard
退款 Tool 准备执行金额为 12,800 元的退款。
Guard 发现这笔金额超过了自动执行阈值,因此不允许直接调用,而是要求人工审批。
此时系统并不是让模型继续“想办法”,而是明确进入审批状态。
第五步:任务挂起
Runtime 创建审批相关的 Suspension,并保存 checkpoint。
当前 Web 请求可以结束,产品界面显示:
Agent 此时不占着一个循环不停运行。
它就停在这里。
第六步:半小时后,人完成审批
财务人员点击“批准”。
审批结果被写回,宿主使用这次审批对应的请求标识恢复任务。
Runtime 从 checkpoint 恢复业务状态和行为树执行状态,然后继续之前的退款流程。
已经完成的订单查询、支付查询和风险判断不需要重新做一遍。
第七步:越过 Commit Boundary,真正执行退款
审批通过以后,退款 Tool 才真正有资格改变外部世界。
对于这种不可逆动作,更完整的 Runtime 路径不是“失败就直接再调一次”,而是先形成一个稳定的 effect identity,记录准备提交的退款动作,再调用支付系统。
如果支付系统明确返回失败,行为树可以按照业务策略走 Retry / Fallback 或人工处理。
但如果出现的是“请求可能已经成功,只是结果丢了”,就不能盲目重试。恢复时应该先根据 effect id / 业务单号向外部系统 Reconcile,确认真实退款状态以后再决定下一步。
这也是为什么 Checkpoint 和 Effect Recovery 要分开:Checkpoint 告诉 Runtime 流程走到退款这里了,Effect Record 则负责回答钱到底退没退。
第八步:完成并留下结果
退款成功后,Agent 更新任务状态,并生成最终结果给用户。
Telemetry 则保留整个过程中重要的 Runtime 事件,方便之后查看任务什么时候开始、为什么挂起、什么时候恢复、调用过哪些能力、最终在哪里结束。
整个过程可以概括成:
flowchart TD
    A["接收任务"] --> B["查询订单 / 支付 / 库存"]
    B --> C["异步任务完成,唤醒 Runtime"]
    C --> D["判断退款条件"]
    D --> E["进入退款子流程"]
    E --> F["Guard 检查"]
    F -->|需要审批| G["Suspend + Checkpoint"]
    G --> H["人工审批"]
    H --> I["Resume"]
    I --> P["Effect Proposal / Prepared"]
    P --> J["执行退款"]
    J -->|明确失败| K["Retry / Fallback / 人工"]
    J -->|结果不确定| R["Reconciliation"]
    R -->|确认未执行| J
    R -->|确认已执行| CMT["补回 Receipt / Committed"]
    J -->|成功并有 Receipt| CMT
    CMT --> L["更新状态并完成任务"]
6. 治理:Guard、Approval、Sandbox 与 Permission
本章用途:解释 Agent 自治运行时边界在哪里。Jianmu 允许 Agent 持续推进任务,但权限、审批、隔离和人工介入必须进入 Runtime 的执行链路,而不能散落在每个 Tool 或业务回调里。
这里的 Runtime 指完整的 Jianmu Agent Runtime,包括运行内核、生命周期、治理、观测和能力层。Runner / Node / State 只是其中的运行内核,Guard、Approval、Sandbox 和 Permission 属于 Runtime 的治理层。
6.1 人如何进入 Agent 的执行闭环
很多人一说“自治 Agent”,第一反应是尽量不要人参与。
但在真实业务里,这通常不现实,也不一定安全。
有些事情模型自己做没有问题,比如整理资料、查询状态、生成草稿;有些事情即使模型判断得很有把握,也仍然应该经过人确认,比如退款、发布、删除、付款或者修改关键业务数据。
所以 Jianmu 里的 HITL(Human-in-the-Loop)更接近一种正常的执行节点,而不是失败后的兜底。
一个典型流程可以是:
Agent 自动处理
   ↓
准备执行高风险动作
   ↓
Guard 判断:需要人工确认
   ↓
任务 Suspend
   ↓
产品界面展示审批信息
   ↓
人批准 / 拒绝
   ↓
生命周期层 Resume
   ↓
继续执行对应分支
这里要分清的是 Runtime 内部不同模块的分工。
Guard 属于治理层,负责判断:这件事能不能直接做,还是必须先问人。
Suspend / Resume 属于生命周期层,负责处理:既然要问人,那任务怎么停下来,之后又怎么接回去。
这样做以后,HITL 不需要被写成一堆业务特判。
而且产品层可以真正利用这个机制做交互。
比如三类 Suspension 可以对应不同 UI:
- 审批:显示风险说明、关键参数、批准/拒绝按钮;
- 用户输入:显示表单,让用户补充字段;
- 外部执行:显示“处理中”,等系统回调。
多 Agent 场景里的消息等待则由 Agent Runtime 处理,产品层同样可以把“正在等待哪个角色返回结果”呈现出来,但它不是这里所说的第四种 Suspension。
这也是为什么 Jianmu 把 Runtime 和宿主产品分开。
Runtime 不应该决定按钮长什么样,也不应该假设交互一定发生在命令行、网页还是 IM 里。它只需要明确告诉上层:现在任务为什么停了,以及恢复时需要什么。
上层产品怎么把这件事呈现给用户,可以完全不同。
同一个 Agent 因此可以跑在 TUI、Tree Studio、Swarm Studio 或业务系统里,而不需要为每种 UI 重写一套运行逻辑。
6.2 Guard / Approval / Sandbox
当 Agent 只做信息整理时,安全问题还比较简单。
一旦它开始真的执行动作,情况就完全不同了。
比如下面这些动作,风险显然不一样:
Jianmu 不希望把这些判断全部交给模型。
模型可以给建议,但“这个动作到底能不能执行”应该由更明确的机制控制。
这里主要有三层。
Guard 负责做执行前判断。
它可以根据策略、预算、调用频率或业务规则,返回几种结果:直接允许、拒绝,或者要求确认。
Approval 负责需要人参与的那部分。
如果 Guard 判断这个动作不能直接执行,Runtime 就可以把任务挂起,等人批准或拒绝,再继续对应流程。
Sandbox 负责执行隔离。
有些动作允许执行,但不应该直接运行在宿主机器或主业务环境里。Sandbox 解决的是“在哪里执行更安全”。
所以这三个东西的关系可以一句话说清:
Guard 决定能不能做,Approval 解决谁来确认,Sandbox 决定在哪里做。
这套机制的重点不是追求“绝对安全”,而是把风险控制从 Prompt 里拿出来。
如果只是告诉模型:
“请谨慎操作,不要执行危险动作。”
这当然有用,但它仍然是一条自然语言要求。
真正进业务以后,系统还需要更硬的边界:哪些 Tool 能用、哪些动作必须确认、预算是多少、代码在哪里执行、出了问题能不能追踪。
Jianmu 的目标就是把这些边界放进 Runtime 的执行链路,而不是只依赖模型自己记得遵守规则。
把这一章放在一起看,Jianmu Agent 内部其实同时存在几条不同的线:
Behavior Tree   → 控制流:谁先执行、失败以后走哪里
Node / Preset   → 执行结构:ReAct、Plan-Execute 等模式怎么落到树上
Typed State     → 数据流:节点之间共享什么、怎么合并、能活多久
Port Binding    → 数据契约:节点的逻辑输入输出怎么映射到业务状态
Model           → 动态判断与生成
Tool            → 原子外部动作
Skill           → 可复用任务能力
Long-term Memory→ 跨任务知识
Checkpoint      → 当前任务恢复
Guard / Approval→ 给真实执行加边界
所以如果只记一句,可以记成:
Tree 管控制流,State / Port 管数据流,Model / Tool / Skill 提供能力,Memory / RAG / Context 管信息进入模型的方式,Checkpoint 管任务恢复,完整的 Agent Runtime 再把这些模块放进同一条可持续、可治理、可恢复的执行链路里。
单独看,每一项都不新鲜。
真正重要的是,它们被放在同一个 Runtime 里以后,Agent 不再只是“模型会不会调工具”,而开始拥有明确的控制结构、数据契约、能力边界和恢复语义。
6.3 Hook、Guard、Approval 的边界
有了 Hook 以后,一个很容易出现的误解是:
“既然 before_tool_call 可以看到和修改参数,那安全检查是不是也都写 Hook 就行?”
我不建议这样理解。
Hook、Guard、Approval 虽然都会“进入执行过程”,但解决的问题不同。
可以直接用这张表记:
| 机制 | 核心问题 | 是否应该承担安全边界 |
|---|---|---|
| Event Bus | 刚刚发生了什么? | 否 |
| Telemetry | 整个运行过程是怎么发生的? | 否 |
| Hook | 我能否在稳定边界观察或扩展执行? | 一般不作为核心安全边界 |
| Guard | 这个动作允许执行吗? | 是 |
| Approval | 这个动作需要谁确认? | 是,人参与决策 |
| Sandbox | 即使执行,它应该在哪里执行? | 是,执行隔离 |
Hook 的主要目标是扩展性。
Guard 的主要目标是策略约束。
Approval 的主要目标是责任和确认。
Sandbox 的主要目标是隔离。
例如一个高风险 Tool:
可以有一个 Hook 记录它的参数,也可以有 Hook 给审计系统发通知。
但真正决定:
“这个动作不允许执行。”
应该是 Guard。
如果策略要求人工确认:
“只有管理员批准才允许执行。”
应该进入 Approval。
最终命令即使被允许,也可能应该在受限 Sandbox 里执行。
所以合理的链路更接近:
flowchart LR
    A["Agent 产生动作"] --> H["Hook\n扩展 / Transform"]
    H --> G["Guard\n策略检查"]
    G -->|需要确认| P["Approval"]
    G -->|允许| S["Sandbox / Executor"]
    P -->|批准| S
    S --> E["Event / Telemetry"]
这里 Hook 很强,但它不应该因为“能修改参数”就变成所有治理逻辑的归宿。
否则一个产品忘了注册 Hook,安全边界就消失了。
这也是为什么本章前面把 Guard / Approval / Sandbox 作为 Runtime 的明确能力,而没有把它们当普通插件。
7. 观测与扩展:Event、Telemetry 与 Hook
本章用途:解释一个正在长期运行的 Agent,外部系统怎么知道它正在发生什么,怎么把这些运行事实组织成可理解的 Trace,又怎么在不修改 Agent 主循环的情况下,把产品和业务逻辑接进执行过程。
前面几章主要站在 Agent 内部看 Runtime:
Behavior Tree 怎么组织执行
ReactiveRunner 怎么持续运行
State / Checkpoint 怎么恢复
Tool / Skill 怎么提供能力
Guard / Approval 怎么控制风险
但一个 Runtime 真正进入产品以后,还会多出另一类问题:
UI 怎么知道 Agent 现在在做什么?
出了问题以后怎么还原刚才的执行过程?
模型调用了多少次、Tool 花了多久?
业务系统怎么订阅 Agent 的生命周期?
模型调用前能不能补一段 Context?
Tool 参数能不能在统一位置做适配?
运行结果怎么投影到不同产品界面?
这些问题都不能靠 Behavior Tree 本身解决。
如果 Runtime 只负责“把任务跑起来”,但外部看不到、接不进去、也没有稳定扩展点,那么它很容易变成一个黑盒。
Jianmu 现在用三套互相配合、但职责不同的机制来处理这件事:
再加上前面讲过的 Guard / Approval,就形成了一条从“看见”到“影响”再到“治理”的链路。
可以先建立一个很粗的产品心智模型:
flowchart LR
    R["Jianmu Runtime"] --> E["Runtime Events\n发生了什么"]
    R --> T["Telemetry\n运行轨迹"]
    H["Hooks\n观察 / Transform"] <--> R

    E --> UI["UI / Studio / External System"]
    T --> TRACE["Trace / Metrics / Eval"]
    H --> EXT["Product / Business Extension"]
这三者都和“运行过程”有关,但不能混为一谈。
7.1 为什么长期运行的 Agent 不能是黑盒
一个只回答一句话的 LLM 应用,黑盒问题没有那么严重。
用户问:
系统回答:
只要结果正确,很多时候用户并不关心中间发生了什么。
但 Agent 一旦真的开始做事,情况就完全不同了。
比如一个编码 Agent 连续运行了二十分钟,最后告诉你:
“任务完成了。”
这时候真正需要知道的可能是:
它看了哪些文件?
改了哪些文件?
调用了多少次模型?
执行了哪些 Shell 命令?
测试到底跑过没有?
中间失败过几次?
为什么选择了这个修复方案?
有没有等待用户确认?
最终结果属于原始 Run,还是某次 Resume?
如果这些东西都看不到,“任务完成”四个字其实没有太大可信度。
长时 Agent 更是如此。
一个任务可能:
10:00 开始
10:03 调用 Tool
10:05 等待外部系统
11:20 收到 callback
11:21 继续运行
11:25 请求人工审批
14:00 用户批准
14:01 Resume
14:06 完成
对这种任务来说,“最终输出”只占整个运行过程很小的一部分。
真正的产品对象已经变成了一次持续存在的 Run。
因此 Runtime 至少需要让外部回答四类问题。
第一类是状态问题:
第二类是过程问题:
第三类是诊断问题:
第四类是扩展问题:
这就是为什么可观测性不是“上线以后顺便加个日志”。
对于长时 Agent,它本身就是 Runtime 设计的一部分。
一个长期运行的 Agent,不仅要能继续跑,还要能让外部知道它为什么在跑、跑到哪里,以及刚刚发生了什么。
7.2 Event Bus:Runtime 里发生了什么
最基础的一层是 Event。
Runtime 每推进一步,其实都在不断发生离散事件:
一次 Run 开始了
一个 Tick 开始了
一个 Model Call 发出了
一个 Tool 开始执行了
一个 Tool 返回了
Agent 被 Suspend 了
Checkpoint 保存了
Agent Resume 了
一条消息到达了
一个 Agent 被创建了
任务结束了
如果这些事实只存在于函数调用栈里,那么外部产品必须直接耦合 Runtime 内部代码才能知道它们。
Jianmu 的思路是:把重要运行事实显式变成 Event。
这些 Event 不是普通日志,而是带有执行上下文的结构化运行事实。这样 UI 收到“Tool 完成”时,不只是看到一条文本,而是可以知道它属于哪次 Run、哪个 Agent、哪个执行位置,并把它投影成真正的产品状态。
这里 Event Bus 并不负责“界面应该长什么样”。
它只提供一个稳定事实:
Runtime 发生了什么。
UI 自己决定怎么解释。
TUI 可以把事件画成 waterfall。
Tree Studio 可以把事件投影成节点状态。
Swarm Studio 可以把 Agent 生命周期和消息事件投影成聊天状态。
外部审计系统也可以只关心 Tool 和 Approval 相关事件。
这就是 Event Bus 最重要的价值:生产者和消费者解耦。
Runtime 不需要知道有多少个消费者,也不需要为了每个产品写一套专用 callback。
在 Swarm Runtime 里还有 Agent 级事件总线,用于 agent_created、agent_paused、message_received 等多 Agent 生命周期和消息事件;其中部分生命周期事件还会桥接到 Runtime 级事件体系。
所以从产品角度看,可以把它们统一理解成:
Jianmu 尽量把重要运行变化变成可订阅的结构化事件,而不是要求上层应用去猜 Runtime 内部发生了什么。
不过 Event 只回答了一件事:
刚刚发生了什么?
如果要回答:
这一整个任务到底是怎么跑过来的?
还需要 Telemetry。
7.3 Telemetry:从事件到完整运行轨迹
Event 是一个个离散事实。
Telemetry 更关心这些事实之间的上下文关系。
例如,下面这些事件单独看都很好理解:
但真正分析一次运行时,我们还需要知道:
这个 Model Call 属于哪次 Run?
这个 Tool Call 是哪次模型判断触发的?
它们是不是属于同一个节点?
这个调用下面还有没有 Child Span?
总共花了多少 Token?
整条链用了多久?
Telemetry 关注的不是某一个事件,而是这些事件之间的关系。
产品层可以把区别简单记成:
例如一次执行可以被还原成:
Run
├── Agent Step
│   ├── Model Call
│   ├── Tool Call
│   └── Tool Call
├── Approval Wait
├── Resume
└── Completed
再叠加耗时、Token 使用、错误和上下游关系,就得到真正可用于 Trace、调试、性能分析、成本统计和 Eval 的运行轨迹。
所以 Event Bus 和 Telemetry 没有被简单合成一个概念:前者强调实时运行事实,后者强调跨模块、跨步骤的可观测链路。
从产品角度看,Telemetry 最终支撑的是几类很实际的能力:
尤其是第 10 章会继续讲的 Capability Loop 和 RSI。
系统如果未来想根据真实执行结果改进 Skill,第一步不是“让模型自我反思”,而是先有足够可靠的运行证据。
没有可观测的执行,就很难有可信的评估;没有可信的评估,就很难谈安全的自动改进。
7.4 Hook:在不修改主循环的情况下进入执行过程
Event 和 Telemetry 解决的是“看见”,但产品真正接入 Runtime 以后,还会出现另一类需求:
能不能在几个稳定边界上接入自己的逻辑,而不去修改 Agent 主循环?
比如:
- 模型调用前补充产品自己的 Context;
- 模型返回后做统一处理;
- Tool 调用前适配业务参数;
- Tool 返回后把结果投影成统一 observation;
- Agent 状态变化时同步 UI 或外部系统。
如果每出现一个这类需求都去改 Runner、LLM Node 或 Tool Executor,最后不同产品会各自拥有一份略有差异的 Runtime,核心执行语义也会慢慢分叉。
Hook 的价值就在这里:Runtime 保持稳定,产品逻辑通过明确的扩展边界接进来。
从产品角度,Hook 可以粗略分成两种语义。
Observe Hook 只观察运行过程,例如记录、同步 UI、发送通知、收集额外指标。它的重点是:
让我知道 Runtime 走到这里了。
Transform Hook 则允许在明确的调用边界修改即将继续传递的数据,例如模型输入、模型结果、Tool 参数或 Tool 结果。
flowchart LR
    C["Context"] --> H1["Hook"] --> M["Model"]
    M --> H2["Hook"] --> R["Model Result"]
    R --> H3["Hook"] --> T["Tool"]
    T --> H4["Hook"] --> O["Tool Result"]
这里最重要的不是具体有哪些 Hook 名字,而是修改能力有明确边界。Hook 可以扩展模型和 Tool 的调用链,但不应该变成一个可以任意重写 Runtime 状态机的万能入口。
7.5 从观察到干预:Hook 能改变什么
Hook 让 Jianmu 不只是 Observable,也变得可以被产品扩展。
比如一个代码 Agent 运行期间,用户手动修改了文件。产品可以在下一次模型调用前,把“文件已经发生变化”补进 Context,而不用让 Runtime 本身理解 IDE 文件变化是什么。
再比如,不同 Tool 可能返回完全不同的原始对象,但产品希望 Agent 后续看到统一的 observation。这个转换也可以放在 Tool 调用边界,而不必把同一套适配逻辑复制进每个 Tool。
这类设计的核心原则是:
扩展点可以进入执行链路,但核心执行语义仍然属于 Runtime。
Hook 可以观察 Suspend,也可以让 UI 随之更新;但真正决定任务如何 Suspend / Resume 的仍然是 Runtime。Hook 可以调整 Tool 参数,但真正决定这个动作是否允许执行的仍然应该是 Guard。
这样产品可以持续增加自己的逻辑,又不需要把 Jianmu Core 变成每个业务系统的定制代码。
7.6 为什么这一层决定了 Jianmu 能不能真正产品化
到这里再看第 12 章会讲到的几个产品,会发现一个共同点:
产品层看到的并不是 Runtime 内部对象本身,而是 Runtime 对外暴露出来的事件、Trace 和扩展边界。
TUI Chat 为什么能显示:
因为 Runtime 不是一个只返回最终字符串的函数。
Tree Studio 为什么能把正在运行的树节点实时画成 Running / Success / Failure?
因为执行状态能够被投影出来。
Swarm Studio 为什么能展示 Agent 生命周期、消息和协作状态?
因为这些变化本身就是 Runtime 中的结构化事件。
同样,产品为什么能在不修改 Jianmu Core 的情况下做:
因为 Hook 给了产品稳定的扩展入口。
因此从产品架构的角度,可以把 Jianmu Runtime 粗略分成两面。
第一面是执行内核:
解决:
Agent 怎么正确地跑。
第二面可以理解成 Runtime 的 Control / Integration Plane:
解决:
外部怎么知道它在跑、怎么接入它、怎么扩展它、怎么约束它。
这里的 “Control / Integration Plane” 是产品层的心智模型,不是说 Jianmu 代码里正式存在一个同名模块。
把两边放在一起看:
flowchart TB
    PRODUCT["TUI / Studio / Business System / Eval"]

    subgraph CONTROL["Runtime Control & Integration Plane"]
        EVENT["Event Bus"]
        TELE["Telemetry / Trace"]
        HOOK["Hook"]
        GOV["Guard / Approval / Sandbox"]
    end

    subgraph CORE["Execution Kernel"]
        STRUCT["Structured Control\nBehavior Tree"]
        REACT["Reactive Execution\nEvent-driven Runner"]
        DURABLE["Durable State\nCheckpoint / Resume"]
    end

    PRODUCT <--> CONTROL
    CONTROL <--> CORE
这张图也解释了为什么“可观测性”这个词其实还不够。
如果只有 Telemetry,外部只能看。
有 Event Bus,外部可以实时订阅运行事实。
有 Hook,外部产品还可以在明确边界进入执行过程。
有 Guard / Approval,真正的干预又有安全和责任边界。
所以这一层更完整的描述应该是:
可观测、可扩展、可干预,同时保持治理边界。
这对 Agent 产品尤其重要。
因为长期 Agent 不可能永远生活在一个框架自己的 Demo 里。
它最终要接进:
如果每接一个产品都要修改 Runtime 主循环,框架很快就会失去统一语义。
所以 Event、Telemetry 和 Hook 的价值,不只是“开发体验更方便”。
它们让 Jianmu 可以保持一个相对稳定的执行内核,同时允许越来越多产品和业务系统接进来。
如果把这一章压缩成一句话,就是:
Jianmu 不只希望 Agent 能运行,还希望一个正在运行的 Agent 可以被看见、被追踪、被产品接入,并在明确边界上被扩展和干预。
这也是 Runtime 从“执行引擎”走向真正产品基础设施时必须补上的一层。
8. 能力层:Model、Tool、Skill、Memory、Context、MCP 与 RAG
本章用途:解释 Runtime 调用什么能力,以及这些能力如何被组织、复用和沉淀。运行内核负责推进,生命周期层负责持续存在,能力层负责让 Agent 真正理解、判断、行动和积累经验。
8.1 Model:Provider、Retry / Fallback 与 Streaming
模型是 Agent 最重要的动态判断来源之一,但 Jianmu 不希望控制逻辑和某一家模型服务绑在一起。
所以模型调用被放在独立的一层:上面的 Tree 和 Node 只表达“这里需要一次模型能力”,下面的 Provider 再负责把这次调用送到具体模型服务。
flowchart LR
    N["Agent / LLM Node"] --> M["统一 Model 层"]
    M --> P["Provider A"]
    M --> Q["Provider B"]
    M --> X["其他 Provider"]
这样同一棵 Tree、同一个 Skill 可以更换模型,而不需要把执行结构一起重写。
这层还统一处理模型调用最常见的可靠性问题。
Retry 面向短时故障。超时、限流或服务暂时不可用时,可以在模型层做有限重试,而不是让每个 Agent 节点各自实现一套错误处理。
Fallback 面向受控降级。主模型持续不可用时,可以切换到预先配置的备用模型。这里的 Fallback 是模型基础设施的降级,不等于 Behavior Tree 里的业务 Fallback:前者是在完成同一次模型调用,后者可能意味着整个业务方案已经换了一条路径。
Streaming 也不只是界面上的“逐字输出”。Agent 的流式响应还可能包含结构化 Tool Call,因此模型层需要保证增量传输结束后,上层仍然得到完整、一致的模型结果,再继续后续执行。
模型调用产生的 Token 使用量等信息也可以在这一层统一进入 Telemetry。
所以可以把这层理解成:
Node 决定什么时候需要模型,Context 决定给模型看什么,Model 层负责把模型能力稳定、可替换、可降级、可流式地接进 Runtime。
8.2 Tool / MCP:连接外部世界
模型能想,但它自己不会真的去改数据库、查订单、发邮件或者调用业务接口。
这些真正产生外部效果的能力,都通过 Tool 接进来。
Jianmu 对 Tool 的理解比较直接:Tool 是 Agent 和外部世界之间的一层明确接口。
它可以是:
- 一个 Python 函数;
- 一个 HTTP API;
- MCP 暴露出来的工具;
- 一个数据库查询;
- 一个外部服务;
- 一段需要在 Sandbox 里执行的代码。
Tool 本身只负责“这件事怎么做”。
至于什么时候做、失败以后怎么办、是否需要人工确认、结果回来以后下一步走哪里,这些不应该全部塞进 Tool 里面,而是交给 Runtime、Behavior Tree 和 Guard 来处理。
这个分工很重要。
否则业务做久以后,很容易出现一种情况:每个 Tool 里面都偷偷带着一点流程逻辑、权限逻辑、重试逻辑和状态逻辑,最后谁也说不清真正的业务流程藏在哪里。
在 Jianmu 里,更希望保持这样的关系:
这样 Tool 可以保持相对简单,也更容易被多个 Agent 或 Skill 重复使用。
8.3 Skill:把经验沉淀成能力
Tool 解决的是“一个动作怎么做”,Skill 解决的是“这一类事情通常怎么做”。
比如:
query_order是 Tool;- “处理一个异常订单”更像 Skill。
后者可能需要先查订单,再查支付,再判断风险,必要时审批,最后决定退款还是人工处理。它已经不是一次原子调用,而是一套完整能力。
所以 Jianmu 里的 Skill 不是简单的 Prompt 别名。
一个 Skill 可以有自己的输入、输出、说明、允许使用的工具和执行方式。Agent 调用 Skill 时,拿到的是一段已经组织好的能力,而不是一句模糊的“你想办法把这件事做了”。
从产品角度看,Skill 的意义在于:能力开始有名字、有边界,也可以被重复使用。
比如产品里可以逐渐形成:
这些东西不再全部藏在某个 Agent 的 System Prompt 里,而是可以被单独管理。
这也是 Jianmu 后面做 Skill Catalog 的原因:Agent 真正长期使用以后,最有价值的不一定是某一次回答,而是积累下来的这些能力。
对企业场景来说,Skill 还有另一层意义。它把“这类事情怎么做”从某个 Agent 的 Prompt 里拿出来,变成一个可以命名、管理和治理的对象。Prompt Skill 保留灵活性,Tree Skill 则进一步提供结构化确定性。
8.4 Tree Skill:企业确定性的主要沉淀方式
Skill 在 Jianmu 里可以有不同的执行方式。
前面第 4 章讲过,行为树在 Jianmu 里有两个层次:一个是 Runtime 内核里的 Agent Loop,一个是能力层里的 Tree Skill。两者不是先后递进关系,也不是两套不同 DSL。Agent Loop 和 Tree Skill 都使用 Node / Tree 表达结构,也都由 ReactiveRunner 推进执行。
复杂编排主要发生在 Tree Skill 这一层。内核循环解决的是现代 Agent 怎么持续 Reason、Act、Observe;Tree Skill 解决的是一套稳定业务能力怎么被组织成可以复用、治理和审计的树。
有些任务变化很大,更适合让模型根据说明临场完成。比如“根据这些材料写一份竞品分析”,很难提前把每一步都固定下来。
这类能力可以保留比较灵活的 Prompt Skill。
但还有一些能力,最开始也许靠模型探索,后来执行方式已经越来越稳定。
比如经过多次执行以后,我们发现“异常退款处理”基本都会走这几步:
这时候继续每次都让模型重新规划一遍,就没有太大意义。更好的做法是把已经稳定的部分从临场判断里拿出来,变成一棵真正可以运行的树。
Jianmu 可以把这套成熟做法沉淀成 Tree Skill。以后其他 Agent 遇到同类问题,可以直接调用这棵树。
Tree Skill 的价值不只是更省 Token。
更重要的是,它把一套已经验证过的执行方式固定成了真正可以运行的结构。企业系统需要的确定性,主要就来自这一层。
模型仍然可以参与其中,比如负责分类、判断或生成内容;但那些已经明确的步骤、重试规则、审批路径和失败处理,不需要每次重新猜。它们进入 Tree Skill 以后,就可以被测试、审计、评审、版本化和回滚。
可以把这个过程理解成:
这也是为什么 Jianmu 里的 Skill 和行为树关系很紧。
同一套 Node / Tree 和 ReactiveRunner,在 Runtime 内核里服务于 Agent Loop,在能力层里服务于 Tree Skill。内核循环保持轻量,主要表达 ReAct 或 Plan-Execute 这样的现代 Agent 循环;复杂编排、企业确定性和能力复用,主要落在 Tree Skill。
8.5 Context / Memory / RAG:模型看到什么、系统记住什么、外部取回什么
Context、Long-term Memory 和 RAG 都和“给模型提供信息”有关,但解决的是几类不同的问题。
Context 回答:
模型这一刻应该看到什么?
当前任务、历史消息、Tool 结果、检索内容、Skill 说明和业务 State,不可能每次全部塞进模型。Context 的作用是从这些信息里组织出当前这一轮真正需要的工作集。
Long-term Memory 回答:
这次任务结束以后,哪些信息以后还值得记住?
比如用户长期偏好、已经确认过的事实、跨会话仍然有用的背景知识。Jianmu 把长期记忆当成可替换的能力层:可以使用语义记忆后端,也可以使用更轻量的存储,并按用户、Agent、Thread 或业务范围隔离。
关键不在于“把所有聊天都永久存下来”,而在于有选择地记录,并在需要时重新检索进 Context。
RAG 回答:
当前任务需要哪些外部知识?
它更像知识接入方式,而不是 Agent 自己的长期记忆。产品文档、业务规则、历史工单、代码库和知识库里的材料,可以通过 RAG 检索出来,再进入当前 Context。这样模型看到的是和本轮任务有关的材料,而不是一整套外部知识库。
所以可以简单记成:
它们之间的关系大致是:
flowchart TB
    S["Typed State\n当前运行事实"] --> C["Context\n本轮模型工作集"]
    M["Long-term Memory\n跨任务知识"] --> C
    R["RAG\n外部知识检索"] --> C
    C --> L["Model"]
这个区分很重要:保存聊天历史不等于长期记忆;长期记忆被检索出来以后,也不意味着每一条都应该进入模型当前 Context。至于 Checkpoint,它属于第 5 章的生命周期与持久化层,处理的是任务中断以后怎么恢复,不属于能力层的信息供给机制。
9. 多智能体:Swarm
本章用途:解释 Jianmu 的多智能体为什么不是“多开几个模型”,而是一组有独立身份、状态和生命周期的 Agent,在同一个 Runtime 中通过消息持续协作,并在任务执行过程中动态形成组织结构。
Jianmu 的多智能体有一句最重要的定调:
Jianmu 的多智能体不是让多个模型互相聊天,而是让多个有独立身份、状态和生命周期的 Agent,在同一个 Runtime 中持续协作。
如果只看表面,多 Agent 很容易被理解成:让几个 LLM 扮演不同角色,然后轮流说话。
但 Jianmu 想做的不是这个层次。
在 Jianmu 里,每个 Agent 都是一个真正运行着的执行体;消息不是几次函数调用之间顺手传递的参数,而是 Runtime 要管理的对象;Agent 之间也不要求永远由一个 Manager 统一分工。随着任务变化,新的 Agent 可以被创建,新的通信关系可以出现,原有成员可以暂停、恢复或退出,整个协作网络会跟着任务一起变化。
这也是这里所说的 Swarm 和 Liquid Topology。
9.1 多 Agent 不等于“多个模型互相聊天”
最简单的多 Agent 往往长这样:
这种方式当然也是多智能体,而且很多任务已经够用。
但从 Runtime 角度看,它更像一个多角色对话流程。每个“Agent”可能只是一次模型调用,真正掌握流程的是外面的 orchestrator。
Jianmu 的 Swarm 不一样。
一个 Agent 被创建以后,会有自己的身份、角色、任务、状态、Mailbox 和 Runner。它可以独立执行,可以暂时没有事情可做,可以收到消息以后再被唤醒,也可以暂停、恢复、失败、重启或被终止。
换句话说,Jianmu 里的 Agent 不是:
而更接近:
Agent
├── 我是谁:Identity / Role
├── 我要做什么:Task
├── 我现在知道什么:State
├── 别人给我发了什么:Mailbox
├── 我怎么执行:Behavior Tree / ReactiveRunner
└── 我现在处于什么阶段:Lifecycle
于是多个 Agent 放在一起以后,问题就不再只是“下一轮谁说话”。
真正的问题变成了:
- 哪些 Agent 现在存在;
- 谁正在运行,谁在等待;
- 一条消息应该发给谁;
- 收到消息以后是否应该立即唤醒;
- Agent 中途失败以后怎么办;
- Runtime 重启以后,哪些消息已经处理过;
- 一个 Agent 能不能自己创建新的 Agent;
- 整个协作结构能不能在执行过程中变化。
这才是 Jianmu Swarm 真正处理的问题。
9.2 Subagent、Agent Team 和 Swarm:同一个 Runtime 的不同自由度
“多 Agent”这个词把很多组织方式放在了一起。对 Jianmu 来说,更重要的不是给它们分三个完全独立的系统,而是理解:它们可以建立在同一个 Multi-Agent Runtime 上,只是开放的组织自由度不同。
Subagent:受约束的父子拓扑
最简单的是 Subagent。
主 Agent 掌握整体任务,把子任务分给下面的 Agent;子 Agent 主要完成被分配的工作,再把结果交回父 Agent。
这种模式的好处是非常直观:谁负责拆任务、谁创建谁、结果回到哪里都比较明确。对于大量“一个主任务拆成几个子任务”的场景,这已经足够。
在 Jianmu 里,不需要为了使用这种简单模式换一套 Runtime。只要把协作规则限制在父子关系里,就可以得到一个更可控的 Subagent 系统。
Agent Team:受约束的固定协作拓扑
再往上可以是一个预先组织好的 Agent Team。
成员、角色和主要协作关系可以在任务开始前确定。Researcher、Coder、Reviewer 都有自己的状态、Mailbox 和生命周期,但不一定允许成员在运行中随意扩张团队或改变全部通信关系。
这种模式保留了多 Agent 的长期状态、异步协作和恢复能力,同时让成员数量、调用路径和成本更容易预测。
Swarm:允许拓扑在运行中变化
真正的 Liquid Swarm 会进一步放开这些约束。
这里不要求所有消息都经过 Manager,也不要求任务开始前就知道最终会出现几个 Agent。Agent 可以根据局部信息直接建立新的协作关系,也可以在 Runtime 允许的范围内创建新的角色。
所以三者更适合被理解成一条自由度梯度:
| 形态 | 组织自由度 | 典型约束 | 可预测性 |
|---|---|---|---|
| Subagent | 低 | 父子关系、主 Agent 分派 | 高 |
| Agent Team | 中 | 固定成员、固定角色、受控通信 | 较高 |
| Liquid Swarm | 高 | 可动态创建、动态通信、动态拓扑 | 更依赖 Runtime 治理 |
这里有一个很重要的产品判断:
Swarm 是 Jianmu 多智能体能力的上限,不是使用门槛。
Jianmu 提供动态创建、消息路由、生命周期和液态拓扑,并不意味着每个产品都应该把这些自由度全部打开。生产系统完全可以根据成本、风险和可控性,把成员数量固定下来、限制谁能创建 Agent、限制通信范围,只使用 Subagent 或固定 Team。
很多真实业务反而应该从更受约束的形态开始,只在确实无法提前设计协作关系的部分释放动态性。
这和 Jianmu 在单 Agent 层的设计是一致的:稳定的部分结构化,不确定的部分留出自治空间。 到了多 Agent 层,同样可以理解成:稳定的组织关系提前固定,真正需要动态协作的部分才交给 Swarm 在运行时形成。
9.3 Agent 是有生命周期的执行体
要做 Swarm,第一件事不是“让 Agent 会发消息”,而是先让 Agent 真正成为 Runtime 里的长期对象。
在 Jianmu 里,Agent 有明确的生命周期。
stateDiagram-v2
    [*] --> Created: create / spawn
    Created --> Running: start
    Running --> Paused: pause
    Paused --> Running: resume
    Running --> Running: message / wake / continue
    Running --> Failed: unrecoverable error
    Failed --> Running: restart policy
    Running --> Stopped: kill
    Paused --> Stopped: kill
    Failed --> Stopped: kill
    Stopped --> [*]
这个设计看起来很基础,但区别很大。
如果所谓“创建一个 Agent”只是调用一次 LLM,那么调用结束以后它也就没了。下一轮再调用时,实际上是另一次请求。
而在 Jianmu 里,一个 Agent 可以:
- 被创建并注册到 Runtime;
- 自动开始执行,也可以由外部手动推进;
- 暂停一段时间;
- 收到新消息后继续运行;
- 因异常触发重启策略;
- 被其他 Agent 或宿主终止;
- 在 Runtime snapshot 恢复后重新存在。
这意味着 Swarm 里的“成员”是真正有时间跨度的。
某一刻 Agent B 没有事情做,并不意味着 B 不存在;它可能只是在等下一条消息。
所以 Jianmu 的多智能体首先是一个生命周期管理问题,然后才是一个“多个模型怎么协作”的问题。
9.4 每个 Agent 都有自己的身份、状态、任务与 Mailbox
生命周期解决“Agent 活不活着”,接下来还要解决“这个 Agent 到底是谁”。
Jianmu 会为每个 Agent 保存自己的 Profile 和运行状态。产品层可以把它理解成每个 Agent 都有一张自己的工作卡片:
Agent B
├── id: agent_b_...
├── role: logistics_specialist
├── task: 调查订单 A1024 的物流异常
├── parent: Agent A
├── state: 当前任务状态
├── mailbox: 收到但尚未处理的信息
├── groups / topics: 当前加入的协作网络
└── runtime status: running / paused / ...
这里最关键的是 Mailbox。
如果 Agent 只是同步调用,A 调 B 时可以直接把参数传进去,B 返回结果就结束。
但 Swarm 里的 Agent 是异步、持续存在的。
A 给 B 发消息时,B 可能正在运行别的任务,也可能刚好处于空闲状态。消息不能因为“对方现在没在函数调用栈里”就丢掉。
所以每个 Agent 都需要自己的消息入口,并且 Runtime 要知道:
- 哪些消息已经到达;
- 哪些已经被处理;
- 当前消费到哪个位置;
- 是否还有未读消息;
- 新消息是否应该把 Agent 唤醒。
这让 Agent 从“被调用的函数”变成了更接近长期运行服务的东西。
9.5 通信本身就是 Runtime 的一部分
这是 Jianmu Swarm 很重要的一个设计点。
在简单多 Agent 系统里,所谓通信可能只是:
这里其实没有真正的通信系统,只是 orchestrator 把 A 的返回值传给了 B。
Swarm 不够用。
因为当 Agent 独立运行以后,一条消息从 A 发给 B,至少会涉及这些事情:
A 发消息
   ↓
Runtime 确认目标
   ↓
写入 Message Store
   ↓
投递到 B 的 Mailbox
   ↓
记录消息序号和消费状态
   ↓
唤醒 B
   ↓
B 把消息同步进自己的 State / Context
   ↓
继续执行
也就是说,通信不是 Agent 外面的一段胶水代码,而是 Runtime 自己要负责的基础设施。
Jianmu 的 AgentRuntime 会统一处理消息路由、Mailbox 投递、事件、Agent 生命周期和调度。
这样做有一个很直接的好处:Agent 不需要知道对方现在是否“在线”。
它只需要把消息交给 Runtime。
对方什么时候处理、是否需要唤醒、消息有没有被消费、失败以后怎么处理,都是 Runtime 的事情。
这和真实的人协作其实有点像。发一封邮件时,我们不会要求对方必须此刻正坐在电脑前;邮件系统负责把消息保存下来,对方之后再处理。
Swarm 想长期运行,就必须有类似的语义。
9.6 消息就是事件:Agent 如何互相唤醒
Jianmu 单 Agent 的核心是事件驱动。
到了 Swarm,这个设计自然延伸成:一个 Agent 发出的消息,可以成为另一个 Agent 的事件。
sequenceDiagram
    participant A as Agent A
    participant R as AgentRuntime
    participant M as Message Store / Mailbox
    participant B as Agent B

    A->>R: send_message(B, content)
    R->>M: 保存并投递消息
    R->>B: wake
    B->>M: 同步未读消息
    M-->>B: incoming messages
    B->>B: ReactiveRunner 继续执行
单 Agent 是:
Swarm 则多了一层:
再往后,B 的行动又可能唤醒 C、D。
于是整个 Swarm 可以理解成:
多个事件驱动的 Agent Runtime,通过消息不断改变彼此的执行状态。
这比“多个 Agent 轮流说话”更接近 Jianmu 的真实运行方式。
Agent 没有新消息、没有异步任务、也没有其他需要处理的工作时,可以保持空闲;一旦消息到达,Mailbox 变化会推动它重新运行。
9.7 Direct / Group / Topic:Swarm 中的通信网络
Swarm 如果只有“父 Agent 给子 Agent 派任务”,最后还是很容易退化成一棵组织树。
Jianmu 的 Runtime 支持三种不同的消息路由方式。
| 方式 | 含义 | 适合什么情况 |
|---|---|---|
| Direct | 精确发给某个 Agent | 我明确知道应该找谁 |
| Group | 发给一个组里的所有成员 | 一组 Agent 需要同步某件事 |
| Topic | 发给所有订阅某个 Topic 的 Agent | 我关心的是“谁对这个信息感兴趣”,而不是具体是谁 |
Direct 很容易理解。
例如 Risk Agent 知道 Logistics Agent 的 ID,可以直接询问:
Group 更像团队频道。
例如几个正在处理同一个订单的 Agent 都加入 order:A1024 组,重要状态可以一次同步给所有人。
Topic 则更有 Swarm 的味道。
比如 Agent A 发现一个潜在高风险事件,只需要向 risk Topic 发布:
发送方不需要提前知道所有接收者是谁。
新的 Agent 只要订阅这个 Topic,就可以进入这条信息流;取消订阅以后就离开。
这意味着 Agent 之间的通信关系本身也可以动态变化。
9.8 去中心化协作:没有必须掌控全局的总指挥
Jianmu Swarm 里可以有父子关系,也可以有负责统筹的 Agent,但不要求一定存在一个掌握全局、决定所有下一步的 Manager Agent。
这是“去中心化”最核心的含义。
一个 Agent 可以根据自己的局部信息做决定:
- 我要不要联系另一个 Agent;
- 我要联系谁;
- 要不要创建新的角色;
- 要不要加入某个 Group;
- 要不要订阅一个 Topic;
- 当前任务是否已经完成。
例如:
Root Agent
    │
    ├────→ Logistics Agent
    │           │
    │           └────→ Payment Agent
    │
    └────→ Risk Agent
                │
                └────────→ Logistics Agent
最开始 Root Agent 只创建了 Logistics 和 Risk。
但 Logistics 在调查过程中发现问题和支付有关,于是它自己创建了 Payment Agent。
随后 Risk 又直接向 Logistics 询问信息。
整个过程中,不需要每一条信息都走:
Runtime 负责通信秩序,但它不替 Agent 决定应该和谁合作。
Runtime 管秩序,Agent 自己决定怎么协作。
9.9 Liquid Topology:组织结构随着任务动态变化
如果只说“去中心化”,还不足以描述 Jianmu 的 Swarm。
另一个关键点是 Liquid Topology。
所谓“液态”,说的是:组织结构不是任务开始前就完全固定的,而是执行过程中根据需要形成。
例如一个任务刚开始时,可能只有一个 Agent:
A 发现需要物流专家:
B 又发现需要支付专家:
与此同时 A 创建了风险 Agent D:
随后 D 发现 B 手里的物流信息对自己有用,于是直接联系 B:
最终网络长成什么样,不一定能在任务开始前画出来。
因此这里有一个很重要的判断:
在 Liquid Swarm 里,组织结构本身就是任务执行的结果。
传统工作流通常先把节点和边画好,然后数据沿着这张图流动。
Jianmu 的 Swarm 可以在运行中改变“有哪些 Agent”“谁和谁通信”“谁订阅什么信息”。
也正因为如此,它更适合那些很难提前把协作结构完全设计好的开放任务。
9.10 Agent 创建 Agent:协作网络可以自己生长
Liquid Topology 能成立,一个很关键的能力就是:Agent 可以创建 Agent。
这不是说所有任务都应该无限创建 Agent。
它真正解决的是:系统运行到一半时,才发现需要一个之前没有准备好的执行角色。
比如一个市场调研 Agent 最开始只负责收集行业资料。
做到一半发现需要检查一家公司的财务风险,它可以创建一个 financial_analyst Agent;财务 Agent 又发现需要核实海外监管信息,再创建一个 regulation_researcher。
这些 Agent 不是工程师提前在 Workflow 里写死的三个节点,而是运行过程中出现的。
在 Jianmu 里,这类 Runtime 操作本身可以作为 Tool 暴露给 Agent:创建 Agent、列出当前 Agent、暂停、恢复、终止、发送消息、加入 Group、订阅 Topic。
因此 Agent 不只是业务能力的使用者,也可以在 Runtime 允许的范围内改变自己的协作环境。
当然,这件事越动态,工程上越难控制。
所以 Jianmu 不是只提供 create_agent() 就结束了,还要继续解决生命周期、消息、重复创建、恢复等问题。
9.11 长时 Swarm:生命周期、Mailbox、Snapshot 与恢复
一个 Swarm 如果只跑几十秒,很多问题都可以先忽略。
但如果它要跑很久,甚至中间跨越等待、重启和故障,事情就复杂了。
假设一个 Swarm 里现在有 8 个 Agent:
- 3 个正在执行;
- 2 个在等其他 Agent 的消息;
- 1 个被暂停;
- 1 个刚刚收到消息还没处理;
- 1 个因为异常正在重启。
这时候进程突然重启。
恢复不能只是说:
“好,我记得之前有 8 个 Agent。”
还需要知道:
- 每个 Agent 的 Profile 和任务是什么;
- 每个 Agent 的 State 是什么;
- 哪些 Agent 原来是 paused / auto mode;
- 每个 Mailbox 已经消费到哪个消息序号;
- 当前加入了哪些 Group;
- 订阅了哪些 Topic;
- Message Store 里还有哪些消息;
- 恢复以后哪些 Agent 应该重新启动。
所以 Jianmu 的 Swarm snapshot 保存的是整个 Runtime 的状态,而不只是几段对话记录。
Swarm Snapshot
├── Agent A
│   ├── Profile
│   ├── State
│   ├── Mailbox Cursor
│   ├── Groups / Topics
│   └── Lifecycle State
├── Agent B
│   └── ...
├── Agent C
│   └── ...
└── Message Store
恢复时,Runtime 会重新建立 Agent Host、State、Runner 和路由关系,并恢复消息存储,再让需要自动运行的 Agent 继续工作。
这也是为什么前面一直强调:
通信本身必须属于 Runtime。
如果消息只存在某几个 Agent 的 Prompt 里,或者只在函数调用过程中短暂存在,那么整个 Swarm 根本没有办法真正恢复。
9.12 Swarm 如何处理重复执行、并发与幂等
动态多 Agent 要真正长期运行,Runtime 不能假设“一切只会发生一次”。重试、恢复和并发都可能让同一个意图再次出现,所以 Jianmu 把这类问题直接纳入 Swarm 的运行语义,而不是要求每个 Agent 自己记得“千万别重复”。
最典型的是 Agent 创建。
Agent A 需要一个 Risk Agent,但创建成功以后,它在拿到返回结果之前发生超时。恢复后如果把“创建 Risk Agent”再做一次,就可能得到两个重复角色。
Jianmu 为这类创建提供稳定的复用标识。Runtime 可以识别:
这不是一个新的创建意图,而是之前那次创建的重试。
于是返回已经存在的 Agent,而不是再次扩张协作网络。
消息发送同样如此。发送方可能已经把任务交给另一个 Agent,却在确认结果之前重启。通过稳定的消息去重语义,重复发送可以被识别和抑制,避免一条业务意图在恢复以后变成两份任务。
创建 Agent
→ stable reuse identity
→ 重试时复用已有 Agent

发送 Message
→ stable dedupe identity
→ 重试时避免重复投递同一意图
再往下,Runtime 还要管理 Mailbox 的消费位置、消息顺序、Agent 生命周期和 Snapshot 恢复。这样一个 Swarm 重启以后,不只是“把 Agent 都重新建出来”,还能够知道哪些消息已经处理、哪些执行体应该继续、哪些操作已经有过结果。
并发则是另一类问题。多个 Agent 可以同时运行、同时发消息、同时发现需要某种能力。Jianmu Runtime 负责把基础设施层的并发秩序管理好,包括消息投递、Mailbox 消费、生命周期推进和重复操作控制。
至于业务本身的并发冲突,例如两个 Agent 同时争抢最后一份库存、同时修改同一笔交易,则应该继续交给业务规则、Guard、Governed Effect 或外部系统自己的事务语义处理。
这个边界很重要:
Jianmu 负责让 Swarm 的执行基础设施具备可恢复、可去重、可持续的语义;业务世界里的资源竞争,则在明确的治理和事务边界上解决。
所以重复执行、并发和幂等不是 Jianmu Swarm 留给使用者自行处理的“已知问题”,而是多 Agent Runtime 本身必须承担的一部分。
9.13 Jianmu 的“去中心化”到底指什么
最后需要把一个边界说清楚。
Jianmu 的 Swarm 是协作逻辑和 Agent 决策层面的去中心化,并不是说整个基础设施完全没有中心。
当前架构里仍然有统一的 AgentRuntime:
                    AgentRuntime
          ┌────────────┼────────────┐
          ↓            ↓            ↓
      消息路由      生命周期       Snapshot
          │            │            │
          └───────┬────┴────┬───────┘
                  ↓         ↓
             Agent A ↔ Agent B
                ↕        ↘
             Agent C ↔ Agent D
AgentRuntime 负责的是基础设施:
- 谁现在存在;
- 消息怎么投递;
- Mailbox 怎么消费;
- Agent 怎么启动、暂停、恢复和终止;
- Group / Topic 的成员关系;
- Runtime 怎么 snapshot 和恢复。
这个统一 Runtime 负责的是基础设施秩序,不等于系统必须存在一个替所有 Agent 做决定的“中央大脑”。在开放的 Liquid Swarm 里,下一步做什么、联系谁、是否需要新的角色,以及协作网络最后长成什么样,都可以由 Agent 根据任务和局部信息动态决定。
但这里还要再强调一个边界:去中心化是 Jianmu 提供的协作能力,不是强制所有产品采用的组织形式。
同一个 Runtime 完全可以被约束成:
Subagent
→ 只允许父 Agent 分派与创建

Fixed Team
→ 成员和角色预先确定

Controlled Dynamic Team
→ 只允许特定角色扩张或建立新通信

Liquid Swarm
→ 在治理边界内动态形成拓扑
产品可以通过固定成员、限制 Agent 创建权限、限制通信范围、设置预算和 Guard,把组织自由度收紧到自己能接受的范围。需要更高成本可预测性时,就少开放动态能力;任务本身难以提前分解时,再逐步释放更多自治空间。
所以更准确的说法是:
Jianmu 用统一 Runtime 管理消息、生命周期、恢复和治理,并允许产品在“固定层级协作”到“动态液态 Swarm”之间选择合适的组织自由度。
这也是 Jianmu 所说的“去中心化”真正想表达的东西:Runtime 有统一秩序,但协作决策不必全部集中在一个 Manager 身上。
如果把这一章压缩成一句话,就是:
Jianmu 提供的是一个统一的多 Agent Runtime:简单场景可以收敛成 Subagent 或固定 Agent Team,复杂开放任务则可以逐步释放动态创建、动态通信和液态拓扑,直到形成长期运行的 Swarm。
10. 从能力沉淀到持续改进
本章用途:说明一套有效流程如何从“一次成功执行”变成可复用 Skill,并进一步进入持续改进:运行产生证据,证据推动候选修改,候选经过验证、晋升和回滚,再重新投入真实执行。
Agent 真正长期运行以后,会自然出现一个问题:
这次任务做成了,下一次还要不要从头再想一遍?
如果答案永远是“要”,那系统虽然会做事,却很难真正积累能力。
一个 Agent 第一次处理异常订单时,可能需要模型临场分析:先查什么、哪些信息有用、什么时候应该审批、失败以后怎么处理。这个过程可以很灵活,甚至带有不少试错。
但如果类似任务已经做过很多次,而且其中大部分步骤已经比较稳定,那么这些经验就不应该永远只存在于某一次对话、某一段 Trace 或某个开发者的脑子里。
Jianmu 希望把这类经验逐渐变成可以再次调用的 Skill。
所以前面几章讲的是“Agent 怎么把一次任务跑完”,这一章开始讨论另一个时间尺度的问题:
Agent 做过的事情,怎么变成它以后会直接使用的能力。
10.1 从一次成功执行到可复用能力
先看一个最简单的例子。
第一次让 Agent 处理“订单支付成功但没有履约”的问题,它可能这样工作:
第一次这样跑完全合理,因为系统还不知道这类问题最合适的处理方式是什么。
但当相似任务出现十次、五十次以后,我们可能会发现:
- 订单状态和支付状态几乎每次都要查;
- “是否符合退款条件”是一个相对稳定的判断步骤;
- 大额退款必须经过审批;
- 退款失败通常要重试或转人工;
- 最后一定要确认真实退款结果,而不能只看 Tool 调用是否发出。
这时候已经出现了一套比较稳定的结构。
真正值得沉淀的不是某一次具体结果:
而是背后的做法:
这就是从“执行结果”走向“能力”的第一步。
不过,一次成功执行不能直接等于一个 Skill。
因为一次成功可能只是碰巧成功。模型临场选择的路径也可能包含很多只适用于当前任务的细节。
所以从执行里沉淀能力时,需要区分两类东西。
第一类是稳定结构:
- 哪些步骤几乎总是需要;
- 哪些前置条件必须满足;
- 哪些失败有固定处理方式;
- 哪些动作必须经过审批;
- 输入和输出应该长什么样。
第二类是仍然需要动态判断的部分:
- 当前用户到底想解决什么;
- 当前异常属于哪一类;
- 一段文本应该如何理解;
- 多个候选方案里哪一个更合适。
前一类适合固化到 Tree、Tool、约束和输入输出契约里;后一类仍然可以留给模型。
所以能力沉淀并不是“把模型去掉”,而是把那些已经不需要每次重新猜的东西固定下来。
最后,一个成熟的能力可能变成:
异常退款 Skill
├── 输入
│   ├── order_id
│   └── 可选的用户补充说明
├── 稳定流程
│   ├── 查询订单
│   ├── 查询支付
│   ├── 判断退款条件
│   ├── 风险检查
│   ├── 必要时审批
│   └── 执行并确认退款
├── 动态判断
│   └── 模型负责异常分类和必要的文本理解
├── 约束
│   └── 大额退款不得自动放行
└── 输出
    ├── result
    ├── reason
    └── transaction_id
到这一步,它就不再只是某次任务的 Trace,而开始成为一个有边界的能力资产。
Jianmu 现有 Skill 系统正是用来承载这种资产。Skill 可以声明自己的名字、说明、输入、输出、依赖工具、执行方式和约束;比较灵活的部分可以用 Prompt Skill,已经稳定的控制结构则可以变成 Tree Skill。
10.2 Capability Loop:执行 → 验证 → 沉淀 → Skill → 复用
如果把上面的过程拉长看,它其实不是一条单向流水线,而是一个循环。
flowchart LR
    A["执行真实任务"] --> B["观察结果与 Trace"]
    B --> C["验证哪些做法真正有效"]
    C --> D["提取稳定结构"]
    D --> E["沉淀为 Skill / Tree Skill"]
    E --> F["后续 Agent 直接复用"]
    F --> G["产生更多执行数据"]
    G --> B
这里我把它称为 Capability Loop。
它和普通“保存一个 Prompt 模板”最大的区别,是中间多了一个很重要的环节:验证。
一个流程被执行过,不代表它值得复用;一个流程成功过,也不代表它应该被推广到所有类似任务。
所以更合理的路径是:
验证可以很简单,也可以很严格。
早期产品里,它可能只是开发者或业务人员检查几次执行 Trace,确认这套流程足够稳定。
再往后,可以有专门的测试集:
一个候选 Skill 只有在这些场景里表现足够稳定,才进入正式能力库。
这点对 Agent 系统尤其重要,因为“能力复用”本身是一种放大器。
如果沉淀的是一个好流程,后续任务都能受益;如果沉淀的是一个错误流程,后续任务也会稳定地重复这个错误。
所以 Capability Loop 不是:
而更接近:
Jianmu 的 Skill 机制让最后一步真正可以落回 Runtime:沉淀下来的能力可以被后续 Agent 发现和调用,再次进入真实任务。
因此能力不是只写在文档里,而是会重新进入 Agent 的运行闭环。
这也是为什么第 8 章里说 Skill 更像“能力资产”。
资产的意义不只是存下来,而是之后还会被使用,并且使用结果还能继续反过来修正它。
10.3 从运行证据到候选能力
能力开始积累以后,下一步很自然:系统能不能根据真实运行结果,主动发现“这套 Skill 还有哪里可以改”?
最稳妥的做法不是让模型直接重写正式能力,而是先把运行过程中留下的 Trace、失败案例、验证结果当成证据。
候选可以来自人,也可以由 Agent 根据这些证据自动提出。无论是谁提出,关键都在于它首先只是 Candidate,不是新的正式能力。
对于结构化 Skill,Jianmu 还可以利用树、节点、输入输出和约束本身做检查:候选结构是否合法、依赖是否完整、是否仍然满足基本契约。这样一部分明显错误的修改可以在真正投入评估前就被挡下来。
这一步最重要的产品原则是:
提出修改 ≠ 接受修改。
系统可以越来越主动地提出能力改进,但“想到一个新版本”和“这个版本值得被使用”必须是两件事。
10.4 验证、晋升与回滚
候选版本真正困难的地方,不是“能不能生成”,而是有没有资格替代当前版本。
所以 Jianmu 把候选和正式能力分开。一个候选至少要经过重新执行和评估,确认它真的带来提升,同时没有明显引入新的安全、成本或回归问题。
flowchart LR
    C["Candidate"] --> V["Validation / Evaluation"]
    I["Current Version"] --> V
    V --> G{"Gate"}
    G -->|Reject| R["保留当前版本"]
    G -->|Accept| N["New Version"]
    N --> A["Activation"]
    A -->|出现问题| B["Rollback"]
这里有两个非常重要的边界。
提出修改 ≠ 接受修改。
模型或者 Agent 可以提出 Candidate,但不能因为“看起来更好”就直接覆盖正式能力。
接受修改 ≠ 正式上线。
一个候选即使通过验证,也可以先形成新版本,再由产品决定什么时候激活;如果后续真实运行发现问题,还应该能够回滚到之前的稳定版本。
所以持续改进不是一个“自动改 Prompt”的动作,而是一条受治理的能力发布链:
这套关系也给未来的自动晋升留下了清楚边界:系统可以逐步提高自动化程度,但能力是否成为正式版本、何时进入真实运行,始终可以被治理。
10.5 从能力积累到持续改进 / RSI
这里说的持续改进,不一定要求重新训练底层模型。
对于 Agent 来说,还有一条很实际的路线:模型本身可以不变,但它长期使用的 Skill、执行结构和能力版本不断变化。
于是 Jianmu 里出现了三个不同的时间尺度:
行为树管一次任务内部的结构,Runtime 管 Agent 在时间上的生命周期,Skill 管能力在多次任务之间的积累。
如果再把前面的 Evidence、Candidate、Validation、Gate、Version 和 Rollback 接起来,就形成一个持续改进循环:
flowchart LR
    T["真实任务"] --> E["运行证据"]
    E --> P["提出能力修改"]
    P --> V["验证 / 评估"]
    V --> G{"Gate"}
    G -->|Reject| T
    G -->|Accept| N["新能力版本"]
N --> T它和“模型反思一句,下次注意”最大的区别,是改进对象可以是一份结构化、可执行、可验证、可回滚的能力。
这也是 Jianmu 对 RSI 最重要的连接点:Agent 的长期成长不必只存在于模型参数或一段越来越长的 Prompt 里,也可以体现在能力资产本身的变化上。
执行产生证据,证据推动能力变化,新的能力再回到真实执行中接受检验。
当这条链持续运行时,Agent 才开始从“每次完成任务”走向“在完成任务的过程中逐渐积累做事的方法”。
11. Jianmu 与主流 Agent 框架的设计取向
本章用途:不做“谁有谁没有”的功能清单,而是比较 LangGraph、AgentScope、AutoGen 和 Jianmu 面对相似问题时,分别选择了什么核心抽象和设计重点。
先说结论:Jianmu 和这些框架解决的问题并没有完全错开。
LangGraph 已经把 durable execution、checkpoint、HITL 和长时运行做得很成熟;AgentScope 有完整的 Agent、Tool、Memory、State、Pipeline 和多 Agent 能力;AutoGen Core 本身就是事件驱动的多 Agent Runtime,并且原生强调消息、Topic、Subscription 和分布式 Agent。
所以如果这一章写成:
那基本是不成立的。
Jianmu 真正不同的地方,是它选择了另一套运行内核:
用事件驱动 Runner 推进行为树 tick,把 Agent Loop 本身放进行为树里运行;再把稳定下来的行为沉淀成 Tree Skill。
这是一种架构选择,不是一张功能勾选表。
本章的比较口径主要参考截至 2026 年 8 月各框架官方文档,重点看它们公开强调的核心抽象和设计中心,而不是比较某个版本里恰好有没有某个 API。
11.1 不同框架在解决同一个问题
如果把今天几个主流 Agent 框架放在一起看,会发现大家其实都在面对几乎同一批问题:
- 模型怎么调用 Tool;
- 多步骤任务怎么组织;
- 状态放在哪里;
- 中间失败以后怎么继续;
- 人怎么介入;
- 多 Agent 怎么协作;
- 一个任务怎么跨越分钟、小时甚至更长时间运行;
- 出问题以后怎么知道刚才发生了什么。
真正不同的是:每个框架选择了什么作为最基本的组织单位。
可以先用一张很粗的表理解:
| 框架 | 更核心的抽象 | 最自然的思考方式 | 设计重点 |
|---|---|---|---|
| LangGraph | State + Node + Edge / StateGraph | 当前是什么状态,下一步走哪个节点 | Stateful orchestration、Durable Execution、HITL |
| AgentScope | Agent / ReActAgent + Message + Application Components | 怎么快速构建一个能力完整的 Agent 应用 | Agent 能力、工具、Memory、工作流、工程生态 |
| AutoGen | Agent + Message + Runtime + Topic / Subscription | 哪个 Agent 收到什么事件,然后怎么响应 | Event-driven Multi-Agent、消息通信、分布式 Runtime |
| Jianmu | Behavior Tree + Reactive Runtime + State | 哪个事件唤醒 Agent,这次 tick 走到哪里 | 行为树 Agent Loop、长时恢复、Tree Skill 沉淀、Swarm |
这张表不是在说四个框架只能做表里那件事。
LangGraph 当然可以做多 Agent;AutoGen 也可以写确定性 Workflow;AgentScope 也有 Pipeline、Routing 和 Handoff;Jianmu 也不是只能写 Behavior Tree。
它只是说明:当一个系统逐渐复杂以后,每个框架最希望开发者用什么方式去理解这份复杂度。
这点比功能数量更重要。
因为一个框架真正长期影响代码结构的,往往不是“有没有 Tool API”,而是:
当任务越来越复杂时,你会把新增的复杂度放到哪里?
是加一个 Node 和 Edge?
是再增加一个 Agent?
是增加一种消息订阅关系?
还是让 Agent Loop 在行为树里运行,再把稳定下来的做法沉淀成 Tree Skill?
这就是不同框架的设计取向开始真正分开的地方。
11.2 LangGraph:State Graph 与 Durable Execution
LangGraph 和 Jianmu 的问题空间重叠很深:两者都认真处理状态、长时执行、Checkpoint 和 HITL,而不只是做一个聊天 Agent SDK。
LangGraph 最自然的心智模型是:
State + Node + Edge。
业务复杂度主要被表达成状态更新和节点之间的转移关系。对于天然就是状态机或流程图的问题,这种方式非常直接;它也有完整的 Durable Execution 和 Subgraph 能力,所以不能把 LangGraph 简化成“只能画一张大图”。
Jianmu 和它真正的差异,不在于谁有没有恢复、HITL 或子流程,而在于默认把 Agent Loop 放在哪里。
例如 Retry、Fallback、Wait 和局部恢复,在 Jianmu 里更倾向成为行为树 tick 过程中的局部控制语义,而不是继续增加全局状态转移关系。
LangGraph 更适合把“状态如何流转”作为第一等概念;Jianmu 更希望把“事件如何驱动行为树 Agent Loop”作为第一等概念。
11.3 AgentScope:Agent-centric Application Framework
AgentScope 更接近一个围绕 Agent 本身 组织完整应用能力的框架:Model、Tool、Memory、Skill、State,以及多 Agent 协作,都从“怎么快速构建一个能力完整的 Agent”出发。
Jianmu 的起点不太一样。它更早追问的是:
所以两边都可以做 ReAct、多 Agent、Memory 和 Skill,差别并不是“谁有谁没有”。
AgentScope 更把 Agent 作为开发体验的中心;Jianmu 更把 Agent 背后的事件驱动 Runtime 和行为树 tick 放在中心。
简单 Agent 应用里,前者的高层抽象会很直接;当控制逻辑、等待、恢复和长期运行开始占据主要复杂度时,Jianmu 的设计取向会更明显。
11.4 AutoGen:Event-driven Multi-Agent Runtime
AutoGen 和 Jianmu 的重叠主要发生在事件驱动多 Agent Runtime这一边。它同样把 Agent、Message、Runtime、Topic / Subscription 放在很核心的位置,所以“事件驱动 Agent + 消息通信”并不是 Jianmu 独有的能力。
AutoGen 更自然的思考方式是:
Jianmu 的 Swarm 外层也有相似思想,但它在单个 Agent 内部又放了一层 Behavior Tree + Reactive Runtime。每个 Agent 被事件唤醒以后,推进的是自己的行为树 tick,而不是一段散落在 Prompt 和业务代码里的循环。
所以可以简单理解成:
AutoGen 更强调 Agent 之间如何通过消息和事件形成系统;Jianmu 同时强调 Agent 之间的事件协作,以及每个 Agent 内部由行为树承载的 Agent Loop。
如果问题的核心就是大规模消息驱动、多 Agent 通信或分布式 Actor Runtime,AutoGen 的取向会非常自然;Jianmu 更关心的是如何把这种多 Agent 协作和单个 Agent 的长期行为树循环放进同一个 Runtime 模型。
11.5 Jianmu:Behavior Tree as Agent Runtime
把前三个框架看完以后,Jianmu 的位置就比较清楚了。
Jianmu 不是因为发现:
“大家都没有 Agent Runtime。”
才出现的。
恰恰相反,Agent Runtime 这件事已经有很多成熟答案。
Jianmu 做的选择是:
如果 Agent 真的要长期运行,那么它的 Loop 能不能由 Behavior Tree 来承载,并由事件驱动的 Runner 持续推进?
这就是 Jianmu 最根本的架构判断。
它的主干可以压缩成:
flowchart TB
    EVENT["Event / Message / External Change"] --> RUNNER["ReactiveRunner"]
    RUNNER --> TREE["Behavior Tree"]
    TREE --> DECIDE["Model / Rule"]
    TREE --> TOOL["Tool / Skill"]
    TREE --> WAIT["Wait / Suspend / HITL"]
    DECIDE --> STATE["State"]
    TOOL --> STATE
    WAIT --> STATE
    STATE --> RUNNER
其中 Behavior Tree 不是 UI 上的一张图,而是 Agent Loop 的执行语义本身。
它负责:
- Sequence;
- Selector / Fallback;
- Retry;
- Condition;
- Wait;
- Decorator;
- Subtree;
- 节点状态传播。
ReactiveRunner 再负责:
- 什么时候 tick;
- 没有事情时怎么等待;
- 异步节点完成以后怎么唤醒;
- 外部交互时怎么 Suspend / Resume;
- 状态和 checkpoint 怎么连接。
再往外扩:
- Tree Skill 把稳定子树变成可复用、可治理的企业能力;
- Swarm 把多个 Agent Runtime 连成动态协作网络;
- Guard / Approval / Sandbox 给执行加边界。
所以 Jianmu 的整体不是:
而更像:
Agent Loop                → Behavior Tree Tick
Reactive Execution        → ReactiveRunner / Event
Durable State             → State / Checkpoint
Enterprise Determinism    → Tree Skill
Multi-Agent Runtime       → Swarm
Governance                → Guard / Approval / Sandbox
Behavior Tree 是运行内核,Tree Skill 是沉淀出口。一个解决“这次怎么跑”,一个解决“稳定做法怎么进入企业系统”。
11.6 为什么 Jianmu 选择行为树
那么问题就来了:
已经有 StateGraph、Agent Framework、Event-driven Runtime,为什么还要再选择 Behavior Tree?
答案不是“行为树比它们高级”。
更准确地说,是 Jianmu 对未来 Agent 的复杂度来源做了一个判断:
当 Agent 从 Demo 进入长期运行以后,复杂度会越来越多地出现在 Loop 的运行语义里,而不只是 Prompt 和 Tool 数量。
比如一个任务最开始可能只有:
后来开始增加:
这时候 Jianmu 希望这些控制关系本身有明确语义。
1. 层级结构是默认能力
Behavior Tree 天然是树。
一个子流程可以直接收进一个子树:
开发者可以只看当前层,也可以继续展开里面的细节。
Graph 当然也有 Subgraph,可以做到类似的层级封装。区别不是“能不能”,而是 Behavior Tree 从一开始就把层级控制当成默认组织方式。
2. Retry / Fallback 是控制语义,不只是跳转关系
例如:
或者:
这类结构对行为树来说非常自然。
它不需要每次重新解释“失败以后下一条边到底指向哪里”。
3. RUNNING 是一等状态
传统一次性函数最熟悉的是:
但长时 Agent 大量时间其实处于:
还没完成。
异步任务没回来、人还没审批、另一个 Agent 还没回复。
Behavior Tree 本身就有 RUNNING 这一执行状态,所以“现在还不能结束”天然属于控制模型,而不是额外塞进去的异常分支。
Jianmu 再把这一点和事件驱动 Runtime 接起来:
这是 Behavior Tree 和 Reactive Runtime 组合起来以后才真正有价值的地方。
4. Tree Skill 承担企业确定性
如果某一段树反复验证以后已经比较稳定,就可以进一步沉淀成 Tree Skill。
于是:
中间不需要把它重新翻译回一段自然语言 Prompt。
这也是企业化最关键的一步。Runtime 里的行为树可以保留 Agent 的动态循环,Tree Skill 则把已经稳定的做法变成可测试、可审计、可版本管理、可回滚的资产。
这对 Jianmu 后面的 Capability Loop 和 RSI 也很重要。
5. 行为树并不要求模型退出控制
这里也容易产生一个误解:
用 Behavior Tree,是不是就变成传统规则系统,不智能了?
不是。
树只负责承载和约束 Agent Loop。
叶子节点里面仍然可以是:
所以 Jianmu 真正追求的是:
稳定的部分结构化,不确定的部分继续交给模型。
而不是把所有决策都提前写死。
这也是 Jianmu 最适合的那类任务:
前面第 2.4 节已经说明了什么时候值得使用 Jianmu。放在框架比较里,更重要的是记住:这些框架大量能力其实彼此重叠,真正长期影响系统结构的是它们选择了什么作为核心抽象。
LangGraph 更偏 State Graph,AgentScope 更偏 Agent-centric Application Framework,AutoGen 更偏消息与事件驱动的多 Agent Runtime;Jianmu 则选择用 Behavior Tree 承载每个 Agent 的 Loop,再用 Reactive Runtime、持久状态、Tree Skill 和 Swarm 把它扩展成长期运行系统。
Jianmu 的问题不是“别人有没有这些能力”,而是:
Behavior Tree 能不能成为复杂、自治、长时 Agent 的自然 Loop 内核?
12. Jianmu 已经长出了哪些产品形态
本章用途:看看同一个 Runtime 目前已经支撑了哪些不同的使用方式和产品形态。
前面几章一直在讲 Runtime、Behavior Tree、Skill 和 Swarm。
到了这一章,可以换一个更产品的视角:
这些底层能力最后到底长成了什么东西?
Jianmu 目前已经不是只有一个 Python API。
同一套 Runtime 已经长出了几种很不一样的产品形态:
TUI Chat      → 单 Agent 工作台
Tree Studio   → 行为树设计与调试工具
Swarm Studio  → 多 Agent 协作空间
Seedbot       → 真实渠道里的业务 Agent
它们看起来差别很大。
一个像终端里的 AI 助手,一个像可视化流程编辑器,一个像多智能体聊天工作台,一个直接接进钉钉这样的真实业务渠道。
但底下复用的东西高度一致:
flowchart TB
    TUI["TUI Chat"]
    TREE["Tree Studio"]
    SWARM["Swarm Studio"]
    BOT["Seedbot / 业务 Agent"]

    TUI --> CORE["Jianmu Runtime"]
    TREE --> CORE
    SWARM --> CORE
    BOT --> CORE

    CORE --> BT["Behavior Tree"]
    CORE --> STATE["State / Checkpoint"]
    CORE --> SKILL["Skill"]
    CORE --> TOOL["Tool / Guard / Sandbox"]
    CORE --> MULTI["AgentRuntime / Swarm"]
所以这一章真正想说明的不是“Jianmu 有四个 Demo”,而是:
Runtime 已经开始和具体产品形态解耦。
同一个执行内核,可以被不同的 UI、渠道和交互方式包起来。
12.1 TUI Chat
TUI Chat 是最接近“直接和一个 Jianmu Agent 一起工作”的产品形态。
它运行在终端里,但并不是一个只有输入框和输出框的聊天窗口。
现在的界面里已经能同时看到:
- 对话历史;
- Agent 当前任务进度;
- 文件变化;
- 代码内容;
- 流式输出;
- Approval;
- Ask User;
- Runtime 状态。
从产品角度看,它更像一个 Agent Workbench。
用户不是只在等模型“回复一句话”,而是在看一个执行体工作的全过程。
例如一个编码 Agent 开始处理任务以后,界面可能经历:
这里很能体现前面第 5 章讲的一个设计:宿主产品不需要自己重新实现 Suspend / Resume。
Runtime 告诉 TUI:
TUI 负责把它变成 Approval Bar。
如果挂起原因是需要用户补充信息,就显示 Ask User Bar。
所以 UI 和执行语义是分开的。
这个分离很重要,因为以后换成 Web、IM 或业务后台时,Runtime 不需要跟着重写。
TUI Chat 还有另一个价值:它把 Runtime 的可观测性直接暴露给了用户。
普通聊天产品通常只展示:
而 Agent 真正复杂以后,中间发生了什么往往比最后一句回复更重要。
例如:
TUI 现在已经有 session persistence、trace 文件和 trace waterfall 等能力,可以把一次运行拆成 run → step → model/tool/child span 来看。
这使它不只是“聊天界面”,也是一个开发和调试 Jianmu Agent 的入口。
因此 TUI Chat 代表的是 Jianmu 的第一种产品形态:
把 Runtime 包装成一个人可以直接操作、观察和干预的单 Agent 工作台。
12.2 Tree Studio
如果说 TUI Chat 是“使用 Agent”,那么 Tree Studio 更接近“设计 Agent 的执行结构”。
Tree Studio 是 Jianmu 的可视化 Behavior Tree 编辑器。
用户可以在画布上拖拽:
然后把它们组织成一棵真正可以运行的行为树。
最关键的是:画布不是一张只用于展示的图。
Tree Studio 保存下来的树定义会被后端编译成真正的 Jianmu Behavior Tree,再交给 Agent / Runtime 执行。
也就是说:
所以 Tree Studio 更像一个 Runtime 的“可视化控制面”。
这和很多 Workflow Builder 有一个细微但重要的区别。
它不是把 Jianmu 的执行结果画出来,而是直接在编辑 Jianmu 的控制结构。
例如产品同事想表达:
在 Tree Studio 里可以直接设计成:
如果主模型再需要最多重试三次:
这就是 Behavior Tree 作为产品交互方式的价值:一些原本藏在代码里的控制语义,可以直接被看见。
Tree Studio 还有一个很关键的出口:导出 Tree Skill。
一个流程在画布里设计、运行、调试稳定以后,可以导出为标准 Skill 目录,包括 SKILL.md 和对应的树定义。
于是产品路径可以变成:
这和第 10 章的 Capability Loop 是直接连在一起的。
Tree Studio 因此不只是“低代码编排器”。
它还可以成为:
从行为树 Agent Loop 走向企业能力沉淀的入口。
未来如果 Jianmu 的自动改进能力继续往前发展,Tree Studio 也天然适合展示:
所以 Tree Studio 代表的是 Jianmu 的第二种产品形态:
把运行中的 Behavior Tree 和沉淀后的 Tree Skill 变成可以被设计、观察、调试和治理的产品对象。
12.3 Swarm Studio
Swarm Studio 对应的是 Jianmu 第 9 章那套多智能体 Runtime 的产品化。
如果直接把底层 AgentRuntime 暴露给用户,产品体验会很抽象:
这些都是 Runtime 概念,不是普通用户愿意直接操作的东西。
Swarm Studio 做的事情,是把它翻译成一个更接近人类协作软件的界面。
它的产品模型可以简单理解成:
Agent Profile 是一个可复用的专家模板。
比如:
把 Profile 放进某个 Workspace 以后,它变成真正参与当前工作的 Workspace Agent。
多个 Agent 再进入 Conversation 协作。
因此用户看到的是:
“我有一组专家,他们在一个工作空间里共同处理事情。”
而底层 Runtime 看到的是:
两层被产品界面隔开了。
Swarm Studio 也没有把所有通信简化成“一个群聊”。
例如 Agent 可以直接私聊另一个 Agent。
这种私聊会形成独立的 Side Thread,而不是在主群里偷偷传一段不可追踪的上下文。
私聊结束后,还要明确决定:
这件事看起来很细,但它实际解决的是多 Agent 系统里非常容易出现的信息断层。
比如:
如果通信只是“模型之间随便聊”,这类信息很容易丢。
Swarm Studio 通过显式的 Channel / Side Thread / Sync-back 语义,让协作关系能够被产品看到和追踪。
另外,Swarm Studio 现在也会持久化:
- Agent Profile;
- Workspace Agent;
- Conversation;
- Message;
- Agent 状态;
- 对话记忆;
- History Snapshot。
这意味着刷新页面或者关闭某一轮交互以后,“团队”不需要从零开始重新生成。
这和第 9 章讲的长期 Swarm 是一致的。
所以 Swarm Studio 真正想产品化的不是:
“多开几个聊天机器人。”
而是:
让一组长期存在、身份明确、可以互相通信的 Agent,拥有一个人类可以进入和观察的协作空间。
这也是 Jianmu 的 Swarm 从 Runtime 走向产品的第一种比较完整的形态。
12.4 Seedbot / 业务 Agent
TUI Chat、Tree Studio、Swarm Studio 都很“Jianmu”。
用户能明显看到 Agent、Tree 或 Swarm 的存在。
但真实业务落地还有另一种情况:用户根本不应该知道底下用了 Jianmu。
Seedbot 就更接近这种形态。
它目前主要面向 DingTalk 渠道。
用户看到的体验可能只是:
但后端实际经历的是:
flowchart LR
    A["DingTalk / Channel"] --> B["Inbound Message"]
    B --> C["Session"]
    C --> D["Jianmu Agent Runtime"]
    D --> E["Skill / Tool / Guard / Sandbox"]
    E --> F["Outbound Message"]
    F --> A
Seedbot 会负责渠道层的事情:
- 收消息;
- 维护 Session;
- 把渠道用户映射到会话;
- 把 Agent 最终结果发回渠道;
- 提供 gateway 和 debug 接口。
而 Agent 怎么执行,仍然复用 Jianmu 的核心能力:
- Behavior Tree / Reactive Runtime;
- Typed State / Checkpoint;
- Skill / Tool;
- Guard / Constraints;
- Context 与运行时依赖。
这说明一个很重要的产品边界:
Jianmu 不要求最终产品长得像 Jianmu。
Runtime 可以完全藏在一个普通业务产品后面。
例如同样的模式可以继续被用于:
用户只看到自己熟悉的渠道和业务界面。
只有开发者知道底下是一个 Jianmu Agent 在持续运行。
Seedbot 因此更像一个参考答案:
怎样把 Jianmu 从框架能力接进一个真实渠道和业务配置体系。
这和做 Demo 的区别很大。
Demo 通常只需要证明:
真实业务还要处理:
Seedbot 就处在 Runtime 和这些真实应用问题的交界处。
12.5 同一个 Runtime,不同产品形态
把四个产品放在一起看,会发现它们其实是在回答四个完全不同的问题。
| 产品形态 | 用户最关心的问题 | Jianmu 暴露出来的核心能力 |
|---|---|---|
| TUI Chat | Agent 现在在做什么,我怎么和它一起工作 | Agent Runtime、HITL、Trace、Session |
| Tree Studio | 这个 Agent 的控制逻辑怎么设计和调试 | Behavior Tree、State、Skill |
| Swarm Studio | 一组 Agent 怎么持续协作 | AgentRuntime、Mailbox、Lifecycle、Message |
| Seedbot / 业务 Agent | 怎么把 Agent 接进现有业务和渠道 | Runtime、Skill、Tool、Guard、Session |
这说明 Jianmu 的产品边界并不应该只定义成“一个 Agent 开发框架”。
更准确地说,它正在形成一个下面这样的结构:
Runtime 是共用的。
产品层决定用户看到什么。
对于开发者,可能最重要的是 Tree、State 和 Trace。
对于普通员工,可能只需要一个聊天窗口。
对于管理多 Agent 的操作者,可能需要 Workspace、Agent Profile 和 Conversation。
对于最终业务用户,甚至连“Agent”这个词都不需要出现。
这种分层还有一个现实意义:Jianmu 的内核能力不需要和某一个 UI 的产品成败绑死。
例如 Tree Studio 可以继续演化成面向开发者的可视化 IDE;Swarm Studio 可以演化成多 Agent 协作工作台;Seedbot 可以演化出多个行业应用。
它们可以共用 Runtime,但产品定位完全不同。
反过来,Runtime 里新增一个真正通用的能力,比如:
也可能同时被多个产品入口复用。
这就是“平台”和“应用”开始分离的地方。
所以这一章最后可以把 Jianmu 的产品结构压缩成一句话:
Jianmu Core 负责让 Agent 可靠地运行,Studio 负责让人看见和控制这种运行,业务应用则负责把 Runtime 接进具体场景。
这几种产品看起来不像同一个东西,但它们其实共享同一套底层判断:
Agent 不应该只存在于一次模型调用里,而应该成为可以被运行、观察、干预、组合和长期托管的执行体。
13. Jianmu 与 Agent Engineering 的演进
本章用途:把 Jianmu 放回近一段时间 Agent 工程的发展里看。这里是行业坐标,不拿外部概念反过来定义 Jianmu。
前面几章一直是在 Jianmu 内部看问题。
这一章换一个视角:为什么最近越来越多 Agent 系统,最后都会开始讨论 Runtime、Harness、Loop、Orchestration、Evals、Memory、Sandbox 这些看起来“不像模型”的东西?
原因其实很直接。
当模型能力还不够强时,大家最关心的是:
但当模型已经能规划、调用工具、写代码、自己修正以后,系统真正容易出问题的地方开始往外移动:
于是 Agent Engineering 的重点逐渐从“把一次模型调用调好”,扩展到:
怎样给模型搭一个可以长期行动、获得反馈、恢复状态并受约束的执行系统。
近一段时间行业里出现的 Harness Engineering、Agent Loop、Durable Execution、Agent Runtime 等讨论,本质上都在回答这个问题的不同部分。
这里先说明一个边界。
本章把这些问题整理成三类:
它们不是严格按年份依次替代的“三代 Agent 技术”,也不是行业统一的正式分类。
尤其 Structured Orchestration 是本文为了描述“复杂执行结构如何被明确组织”而使用的概括性名称。
更准确地说,这三类问题会同时存在,而且彼此重叠:
flowchart TB
    H["Harness Engineering\n环境、工具、状态、安全、反馈"]
    L["Loop Engineering\n观察、决策、行动、反馈、继续/停止"]
    O["Structured Orchestration\n分支、Retry、Fallback、Wait、并行、子流程"]

    H --> R["Agent Runtime Engineering"]
    L --> R
    O --> R
Jianmu 并不是先看到这些词,再照着它们设计。
更像是做复杂 Agent 的过程中,先后碰到了同一批工程问题,最后发现自己的架构和行业正在讨论的这些方向自然汇合了。
13.1 Harness Engineering:可靠执行环境
“Harness”这个词原本就有“把某个能力固定住、接上周围设施,让它可以稳定工作的装置”这种意思。
放到 Agent 里,也可以用很直白的话理解:
模型是发动机,Harness 是发动机真正装进车以后周围那一整套东西。
如果只有模型,最简单的系统可能是:
但一个真正工作的 Agent 往往需要:
                 Model
                   │
        ┌──────────┼──────────┐
        ↓          ↓          ↓
      Tools      Context     Memory
        │          │          │
        ├────── Environment ──┤
        │          │          │
     Sandbox     State      Files
        │          │          │
        └──── Guard / Approval ┘
                   │
              Trace / Eval
这些东西共同决定模型到底能不能可靠工作。
2026 年 OpenAI 在总结 Codex 的实践时直接用了 Harness Engineering 这个词,重点也不是“再训练一个更聪明的模型”,而是设计环境、工具、文档、Guardrail、验证和反馈循环,让 Agent 能够稳定地完成端到端工作。
Anthropic 在讨论 long-running agent harness 时也强调了类似问题:一个任务一旦跨越多个 context window,就必须想办法把进度、环境和可交接的信息留给下一轮执行,否则模型每次都像一个刚上班、什么都不知道的新工程师。
所以 Harness Engineering 比“长时运行”更宽。
长时运行是其中很重要的一部分,但 Harness 还包括:
- Agent 能看到什么;
- Agent 能用什么工具;
- 文件和代码环境是什么;
- 哪些动作允许执行;
- 哪些动作需要审批;
- 状态如何保存;
- 失败如何被观察;
- 如何验证任务真的完成;
- 上一次执行留下了什么可继续利用的东西。
从这个角度回头看 Jianmu,会发现很多看起来分散的能力,其实都属于 Harness:
Typed State       → 把运行事实留住
Checkpoint        → 让任务可以恢复
Context           → 决定模型这一轮看到什么
Tool              → 给模型行动能力
Skill             → 给模型可复用能力
Sandbox           → 控制代码在哪里执行
Guard             → 判断动作能不能做
Approval          → 让人进入高风险决策
Telemetry / Trace → 让执行过程可观察
这些模块单独看都不是“智能”。
但它们决定了智能能不能真正落地。
一个很典型的例子是代码 Agent。
模型可能已经知道应该:
但如果 Harness 没有准备好,事情会迅速变成:
模型再聪明也很难解决一个根本不存在的执行环境。
所以近一段时间 Agent 系统越来越像传统软件工程,这不是倒退。
恰恰相反,是因为模型开始真的能够承担工作以后,软件工程里那些原本由人默默处理的问题,必须被显式交给 Harness。
对于 Jianmu 来说,Harness Engineering 最对应的不是某一个模块,而是整套 Durable Runtime 思想:
不要只给模型几个 Tool,而要给 Agent 一个能长期生活和工作的执行环境。
这和第 5 章讲的长时运行直接连在一起。
Agent 可以等待、挂起、恢复、收到新事件再继续;状态和审批不会因为一次请求结束就消失。
所以“Long-running”更像 Harness 最容易被用户感受到的结果之一,而不是 Harness 的全部定义。
13.2 Loop Engineering:自治执行闭环
如果 Harness 解决的是:
Agent 在什么环境里工作?
那么 Loop Engineering 解决的是:
Agent 怎么持续自己往前走?
Agent 和普通 LLM 调用最明显的区别,就是它不是一次输入、一次输出。
一个最基本的 Agent Loop 可以写成:
Anthropic 对 Agent 的一个很实用的定义,就是模型在一个自我驱动的循环里 plan、act、observe、adjust,直到任务完成或者需要人介入。
OpenAI 在 Agents SDK 和 Codex 的工程说明里也都把 loop 当成 Agent 的核心运行方式:模型可以连续多轮调用 Tool、接收执行结果,再决定下一步,直到满足退出条件。
所以“自治”不是:
模型第一次就把完整计划想对。
真正的自治更接近:
模型可以根据环境反馈不断重新决定下一步。
这两者差别很大。
例如一个 Agent 想解决测试失败:
如果系统只允许模型一次性输出一个 20 步计划,然后机械执行到底,它反而很难自治。
因为真实环境会不断给新信息。
所以 Loop 的核心不是“循环调用 LLM”这么简单。
真正需要设计的是:
- 每一轮给模型什么状态;
- Tool 结果怎么返回;
- 哪些变化应该触发下一轮;
- 什么算任务完成;
- 什么情况下应该 Retry;
- 什么情况下应该停止;
- 什么情况下应该问人;
- 如何避免无限循环;
- 上下文越来越长时怎么办;
- 一轮执行失败以后从哪里继续。
这就是为什么可以把它叫 Loop Engineering。
一个 naive loop 很容易写:
真正困难的是 not done、state、execute 和异常路径。
Jianmu 的自治运行,本质上也可以放到这个坐标里理解。
但它没有把 Loop 写成一个裸 while True。
它把循环落到了事件驱动 Runner 和 Behavior Tree tick 上:
flowchart LR
    E["Event / State Change"] --> W["Wake"]
    W --> T["Behavior Tree Tick"]
    T --> D["Model / Condition 决策"]
    D --> A["Tool / Skill / Action"]
    A --> S["State Update"]
    S --> Q{"还有工作吗?"}
    Q -->|有| T
    Q -->|没有,等事件| E
    Q -->|需要外部输入| H["Suspend"]
    H --> E
这里有两个特点。
第一,Loop 是事件驱动的。
没有事情发生时,Agent 不需要不停问模型:
“现在有新情况吗?”
它可以停下来。
等 Tool 完成、用户回复、审批通过、其他 Agent 发消息,再被 Runtime 唤醒。
第二,Loop 的每一轮都是一次行为树 tick。
下一步允许做什么、某个失败怎么处理、什么时候应该等待,都在这次 tick 中由 Behavior Tree 给出控制语义。
模型仍然可以在骨架里的动态节点做判断。
所以 Jianmu 对 autonomy 的理解不是:
而是:
这也是为什么第 1 章里说:
模型负责判断下一步做什么,Jianmu 用事件驱动的行为树 tick 让这个判断持续、可控地变成行动。
Loop Engineering 对应的正是这句话里的“持续”。
13.3 Structured Orchestration:复杂控制结构
Agent 能持续循环以后,很快还会遇到第三类问题:
循环里面的控制逻辑越来越复杂怎么办?
最开始,一个 Agent 可能只有:
后来业务开始增加规则:
主方案失败重试 3 次
还是失败就走备用方案
高风险动作先审批
某些外部任务需要等待 callback
两个查询可以并行
一部分流程必须完成以后另一部分才能开始
某一段成熟做法以后还要沉淀成 Tree Skill
如果所有控制都继续塞进一个 ReAct Prompt 里,模型就必须同时负责两件事:
任务越长,第二部分越容易变成负担。
因此 Agent 工程里一直存在 workflow / graph / routing / handoff / evaluator-optimizer 这些结构化编排方式。
Anthropic 在早期总结 Agent architecture 时,就明确区分了两类系统:
但真实产品通常不会真的二选一。
很多系统最终会变成:
Loop 有明确运行语义,语义判断仍然交给模型。
例如:
这里第二步是 Agentic 的,整体控制结构又是确定的。Jianmu 关心的正是这种混合形态:Agent Loop 不能失去动态判断,但稳定控制关系也不能一直放在 Prompt 里。
所以本章用 Structured Orchestration 来概括这一类工程问题。
为什么不用“Graph Engineering”?
因为 Graph 是一种非常重要的实现方式,但不是唯一的结构化编排方式。
结构化控制可以用:
- 普通代码;
- State Machine;
- DAG;
- State Graph;
- Behavior Tree;
- Workflow DSL;
- Actor / Message Protocol;
- 多种结构混合。
真正的问题不是“有没有画 Graph”,而是:
哪些控制关系应该从 Prompt 里拿出来,进入 Runtime 的行为树 tick;哪些稳定做法应该进一步沉淀成 Tree Skill?
这正是 Jianmu 和很多 Agent 框架选择开始分开的地方。
LangGraph 的回答偏向:
AutoGen Core 的回答偏向:
而 Jianmu 的回答是:
也就是 Behavior Tree。
Behavior Tree 对 Jianmu 最有吸引力的地方,不只是“能画成树”,而是它已经给很多常见控制问题提供了局部语义:
例如:
可以直接表达成:
再例如:
可以局部变成:
这些控制关系被放在节点附近,而不需要散落在很多全局跳转条件里。
这就是第 11 章所谓:
Jianmu 把“行为树如何推进 Agent Loop”作为更靠近核心的概念。
Structured Orchestration 还有另一个意义:给 autonomy 设一个可理解的形状。
如果完全没有结构,Agent 的每一步都由模型重新决定,灵活性很高,但系统也更难预测和验证。
如果所有路径全部提前写死,模型几乎没有自主空间,系统也就不再像 Agent。
Jianmu 想处在中间:
所以 Structured Orchestration 对应的是 Jianmu 设计目标里的“复杂编排”。
它不是为了让流程看起来更复杂,而是为了让复杂度有地方可放。
13.4 Jianmu 为什么会自然汇聚到这些问题
把前三节放在一起,就可以重新看 Jianmu 的三个早期核心目标:
它们和前面的三类 Agent Engineering 问题确实有很强的对应关系:
| Jianmu 最初关注的问题 | 更大的 Agent Engineering 视角 | Jianmu 里的主要承载方式 |
|---|---|---|
| 长时运行 | Harness / Durable Runtime | State、Checkpoint、Context、HITL、Guard、Sandbox |
| 自治运行 | Loop Engineering | Event-driven Runner、Behavior Tree Tick、Model/Tool feedback loop |
| 复杂编排 | Structured Orchestration | Behavior Tree、Decorator、Retry、Fallback、Subtree |
但这张表不能理解成一一等号。
Harness 不只负责长时运行;Structured Orchestration 也会影响 Loop;State 同时属于 Harness 和控制逻辑。
这只是帮助理解 Jianmu 为什么会走到今天这套架构。
最开始可能只是觉得:
Agent 的流程复杂以后,需要 Behavior Tree。
但一棵树真正开始执行以后,很快就会出现:
节点要异步等待
   ↓
需要 ReactiveRunner
   ↓
等待过程中要保存状态
   ↓
需要 Checkpoint
   ↓
有人要审批
   ↓
需要 Suspend / Resume
   ↓
真实 Tool 有风险
   ↓
需要 Guard / Sandbox
然后一个 Agent 还不够:
再往后,任务做得越来越多:
所以 Jianmu 后来变得“重”,不完全是因为想把功能做全。
更重要的原因是:只要接受“Agent 是一个长期运行的执行体”这个前提,很多 Runtime 问题会一个接一个自然出现。
这也解释了为什么 Jianmu 最终比“行为树 Agent 框架”这个名字覆盖得更广。
Behavior Tree 仍然是 Loop 内核。
但仅仅有 Tree,解决不了:
这些最后都属于 Runtime。
所以如果今天重新给 Jianmu 一个更工程化的定位,我会把它概括成:
Jianmu 在做的是 Agent Runtime Engineering。
它用事件驱动 Runner 和 Behavior Tree tick 解决 Agent Loop 怎么运行的问题,用状态与恢复解决时间问题,再用 Tree Skill 和 Swarm 把 Runtime 扩展到能力积累与多智能体协作。
可以画成:
flowchart TB
    M["Model Intelligence"] --> RUNTIME

    subgraph RUNTIME["Jianmu Agent Runtime"]
        BT["Behavior Tree Tick\nAgent Loop"]
        LOOP["Reactive Runner\nEvent-driven Autonomy"]
        DURABLE["Durable State\nLong-running & Recovery"]
        SKILL["Tree Skill\nEnterprise Determinism"]
        SWARM["Swarm\nMulti-Agent Collaboration"]
        GOV["Governance\nGuard / Approval / Sandbox"]
    end
这也让 Jianmu 和“模型能力”的关系更清楚。
Jianmu 并不试图替模型变聪明。
模型能力增强以后,Jianmu 反而应该让更多动态判断回到模型。
Runtime 真正应该保留的是那些模型再聪明也不能只靠 Prompt 保证的东西:
因此一个更强的模型,并不会让 Runtime 消失。
很多时候恰恰相反:模型越能自主行动,系统越需要一个可靠 Harness、清楚的 Loop 和明确的执行边界。
从这个角度看,Jianmu 的三个设计目标并不是三个孤立功能:
它们最终汇聚到同一个问题:
当模型开始从“回答问题”变成“持续行动”以后,谁来负责行动过程本身?
Jianmu 给出的答案是 Runtime。
所以这一章最后可以用一句话把 Jianmu 放回 Agent Engineering 的演进里:
模型让 Agent 能做决定;Harness 给它可靠的工作环境;事件驱动 Runner 和行为树 tick 让 Agent Loop 可以持续运行;Tree Skill 把稳定下来的做法沉淀成企业可用的确定性能力。Jianmu 想做的,是把这些能力收进同一个 Agent Runtime。
14. 总结:Jianmu 的设计哲学
本章用途:把全文压缩成几条真正值得记住的设计判断。
前面十章已经讲了很多东西:Behavior Tree、ReactiveRunner、State、Checkpoint、HITL、Skill、Swarm、Guard、Studio,也比较了 LangGraph、AgentScope 和 AutoGen。
如果最后只记住一堆模块名,这篇文档其实没有完成任务。
Jianmu 真正想表达的不是:
而是一套对 Agent 的基本判断。
最核心的起点只有一个:
Agent 不应该被看成一次模型调用,而应该被看成一个可以持续存在、持续行动、持续积累能力的执行体。
一旦接受这个前提,后面的很多设计其实都会自然出现。
14.1 Agent 是有生命周期的执行体
最简单的 LLM 应用通常是一次请求:
任务结束,请求也结束。
但真实 Agent 经常不是这样。
它可能:
- 做一半等一个接口;
- 等人审批;
- 等另一个 Agent 回复;
- 暂停几个小时以后再继续;
- 中途失败并重启;
- 一直在线,持续接收新任务。
所以对 Jianmu 来说,一个 Agent 更接近:
它会被创建,会运行,会等待,会被唤醒,会暂停,会恢复,也会终止。
这也是整套架构最重要的变化。
如果 Agent 只是一轮请求,那么很多东西都可以放在应用代码里临时处理。
但当 Agent 真的跨时间存在以后:
这些问题就不再是 Prompt 能解决的了。
它们需要 Runtime。
所以 Jianmu 的第一个设计判断可以写成:
先把 Agent 当成长期存在的执行体,再讨论它有多聪明。
14.2 模型负责判断,Runtime 负责让事情继续发生
Jianmu 并不希望把模型的判断能力重新写回规则系统。
模型最有价值的地方仍然是处理那些难以提前枚举的问题:
这些问题应该尽可能交给模型。
但模型不应该同时承担所有运行时责任。
比如:
这些问题如果也靠模型“记得”,系统会非常脆弱。
所以 Jianmu 一直在做一层职责分离:
这也是全文反复出现的那句话:
模型负责判断下一步做什么,Jianmu 用事件驱动的行为树 tick 让这个判断持续、可控地变成行动。
这里的“持续”很重要。
Agent 的价值不只是偶尔做对一个决定,而是把一连串决定和行动真正推进到任务结束。
Runtime 负责让这条链不断掉。
14.3 稳定的部分结构化,不确定的部分交给模型
Jianmu 选择 Behavior Tree,并不是因为相信所有任务都应该提前写死。
恰恰相反。
真正适合 Agent 的任务,本来就包含大量不确定性。
但“不确定”也不意味着所有东西都应该每次由模型重新决定。
例如:
这些已经稳定的控制关系,没有必要每一轮都提醒模型:
“记住哦,失败三次以后要换方案。”
它们更适合直接进入执行结构。
因此 Jianmu 的一个核心原则是:
稳定的部分结构化,不确定的部分继续交给模型。
可以简单理解成:
Behavior Tree 在这里不是“替代 Agentic behavior”,而是在承载 Agentic behavior 的运行循环。
一个叶子节点完全可以还是 ReAct、LLM、RAG、Tool 或另一个 Agent。
树负责的是:
所以 Jianmu 追求的不是把所有行为都变成确定流程,也不是让模型拥有没有边界的自由。
它更关心的是:
哪些东西值得确定,哪些东西必须保持开放。
这也是 Behavior Tree 作为 Loop 内核真正有意义的地方。
14.4 等待、失败、人介入和恢复都应该是正常运行状态
很多 Demo 默认任务世界是同步的:
真实世界不是这样。
一个 Agent 很可能大部分时间都在等:
如果系统把“等待”当异常,长时 Agent 很快就会变得非常别扭。
所以 Jianmu 的另一个设计判断是:
等待不是异常,而是 Agent 生命周期中的正常状态。
同样,Human-in-the-Loop 也不应该被理解成:
“Agent 不够聪明,所以失败了,需要人救场。”
很多业务动作本来就必须有人负责最终决策。
例如:
这时人介入不是 Agent 能力不足,而是系统治理的一部分。
所以 Jianmu 把 Suspend / Resume、Approval、Guard 和 Sandbox 都放进 Runtime,而不是当作外围补丁。
失败也一样。
真正可靠的系统不是假设永远不失败,而是清楚定义:
因此 Jianmu 所谓 Durable,不只是“把 State 保存到磁盘”。
更重要的是:
任务经历等待、中断和故障以后,执行语义还能保持一致。
这也是为什么 Checkpoint、Tree State、Suspension Record、Mailbox Cursor 和幂等语义都值得存在。
14.5 Tree Skill 让能力积累,Swarm 让多个执行体持续协作
前面的几个设计主要解决:
一个 Agent 怎么把事情做完。
但 Jianmu 后来又自然出现了两个更大的时间尺度。
第一个是:
同一个 Agent 做过很多任务以后,能不能留下能力?
这对应 Skill。
第二个是:
一个 Agent 做不完的事情,多个 Agent 能不能长期协作?
这对应 Swarm。
所以可以把 Jianmu 看成四个尺度:
一次任务内部
Behavior Tree Tick 管 Agent Loop
        ↓
一段时间上的任务
Runtime 管生命周期、事件和恢复
        ↓
很多次任务之间
Tree Skill 管稳定能力的积累和复用
        ↓
多个执行体之间
Swarm 管通信、生命周期和动态协作
Skill 让成功经验不必永远停留在某一次 Trace 里。
一段已经验证稳定的做法,可以被整理成 Prompt Skill,也可以进一步变成 Tree Skill。企业化真正需要的确定性,主要就在 Tree Skill 里形成。
以后其他 Agent 再遇到相似问题,就不一定需要从头探索。它调用的是一套已经被运行、调试、审计和版本化过的树。
Swarm 则把同样的 Runtime 思想扩展到多个 Agent。
Jianmu 的多智能体不是:
而是:
其中通信本身属于 Runtime。
消息可以成为事件,事件可以唤醒另一个 Agent;Agent 可以创建新的 Agent,加入 Group、订阅 Topic,整个协作网络可以在任务过程中发生变化。
因此 Swarm 并不是和单 Agent Runtime 完全不同的一套思想。
它更像把同样的事件驱动机制放大了:
而 Skill 又让这些 Agent 使用的能力本身可以继续沉淀。
所以 Jianmu 后面真正有意思的方向,是这几件事开始连接起来:
这也是为什么持续学习和 RSI 会自然出现在 Jianmu 的长期演进里。